DDL
注意:Machbase 8.5 以降では、一般ユーザーがこのページの
CREATE/DROP系の文を実行するには、MACHBASEDBに対するデータベース権限が必要な場合があります。権限の詳細は、ユーザー管理のGRANT/REVOKEを参照してください。
CREATE TABLE
構文
create_table_stmt:
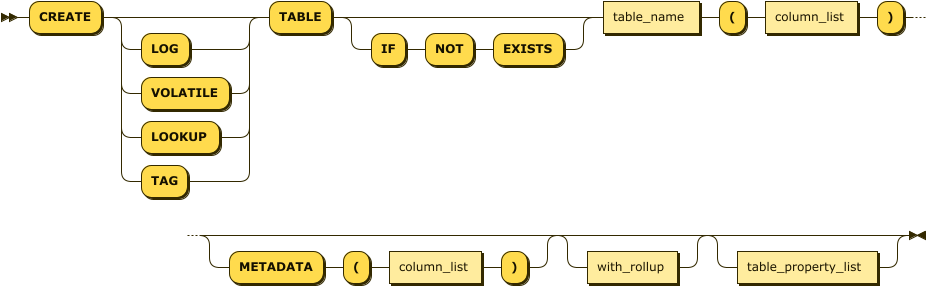
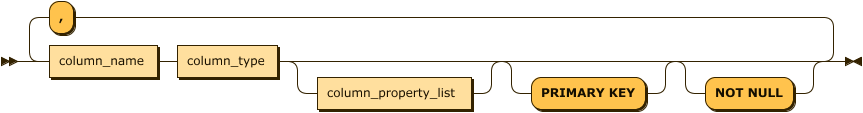
column_list:
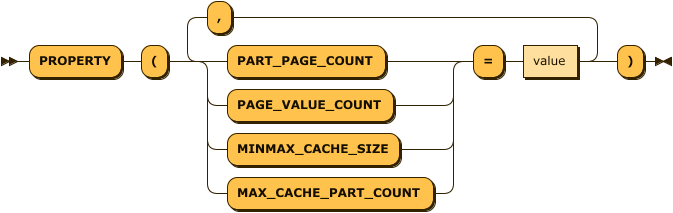
column_property_list:
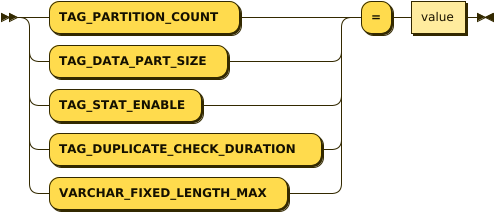
table_property_list:
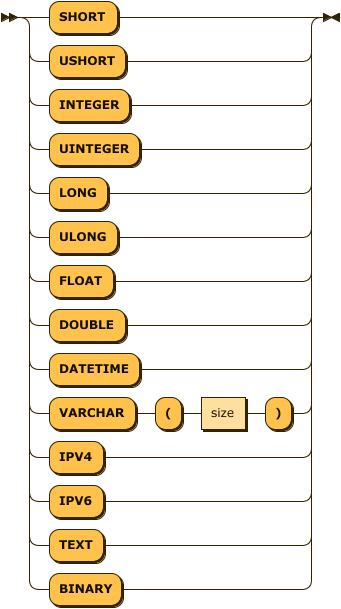
column_type:
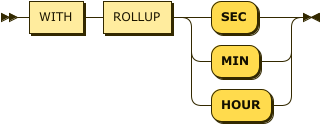
with_rollup:
LOG テーブルの作成
-- 5 列の LOG テーブル ctest を作成
CREATE TABLE ctest (id INTEGER, name VARCHAR(20), sipv4 IPV4, dipv6 IPV6, comment TEXT);
TAG テーブルの作成
TAG テーブルには、PRIMARY KEY 列と軸列が必要です。時間軸は DATETIME BASETIME または DATETIME BASE TIME、距離軸は DOUBLE/LONG/ULONG に BASE DISTANCE または BASEDISTANCE を指定します。SUMMARIZED は任意で、ロールアップや統計が必要な値列に使用します。
-- TAG テーブルを作成
CREATE TAG TABLE tag_time (name VARCHAR(20) PRIMARY KEY, time DATETIME BASETIME, value DOUBLE SUMMARIZED);
CREATE TAG TABLE tag_time_ext (name VARCHAR(20) PRIMARY KEY, time DATETIME BASETIME, value DOUBLE SUMMARIZED, value2 FLOAT, int_column INT);
CREATE TAG TABLE tag_distance (name VARCHAR(20) PRIMARY KEY, distance_m DOUBLE BASE DISTANCE, value DOUBLE, quality INT);
CREATE TAG TABLE tag_distance_meta (name VARCHAR(20) PRIMARY KEY, distance_m LONG BASEDISTANCE, value DOUBLE) METADATA (route_id VARCHAR(20));
距離軸の型は DOUBLE、LONG、ULONG だけです。WITH ROLLUP は時間軸の Tag テーブルでのみ使用できます。TAG メタデータの JSON 列と JSON INDEX(...) の宣言は、Tag メタデータを参照してください。
テーブル名と列名の規則
テーブル名と列名には英数字を使用します。特殊文字を使用する場合は、名前を二重引用符(")で囲みます。
CREATE TABLE special_tbl ( "with.dot" INTEGER );IF NOT EXISTS
テーブルがすでに存在してもエラーにしません。ただし、既存テーブルの構造が CREATE TABLE 文の構造と同じかどうかは検証しません。
既存テーブルと同じテーブル型の場合だけ有効です。
テーブルの種類
| テーブルの種類 | 説明 |
|---|---|
| LOG | CREATE と TABLE の間にキーワードを指定しない場合に作成されるログテーブルです。 |
| VOLATILE | すべてのデータを一時メモリに保持する一時テーブルです。Log テーブルと結合して結果を向上させられますが、Machbase サーバーが停止すると、データはすぐに失われます。 |
| LOOKUP | VOLATILE_TABLE と同様に、すべてのデータをメモリに保持し、クエリーを高速に処理できるテーブルです。 |
テーブルプロパティ
テーブルの属性を指定します。
| プロパティ名 | 使用できるテーブルの種類 |
|---|---|
| TAG_PARTITION_COUNT | TAG |
| TAG_DATA_PART_SIZE | TAG |
| TAG_STAT_ENABLE | TAG |
| TAG_DUPLICATE_CHECK_DURATION | TAG |
| VARCHAR_FIXED_LENGTH_MAX | TAG |
TAG_PARTITION_COUNT(既定値:4)
TAG テーブルで使用できるプロパティで、TAG テーブルを内部で何個のパーティションテーブルに分けて保存するかを指定します。タグ数やサーバー性能に合わせて設定します。
TAG_DATA_PART_SIZE(既定値:16MB)
TAG テーブルで使用できるプロパティで、パーティションテーブルごとのデータサイズを指定します。
TAG_STAT_ENABLE(既定値:1)
TAG テーブルで使用できるプロパティで、タグ ID ごとの統計情報を保存するかどうかを指定します。
TAG_DUPLICATE_CHECK_DURATION(既定値:0、最大:43200)
TAG テーブルで使用できるプロパティで、現在のシステム時刻を基準に、重複を除去できる期間を分単位で指定します。重複を除去できるのは、現在のシステム時刻から指定期間内のデータだけです。0 の場合は重複除去を行いません。
VARCHAR_FIXED_LENGTH_MAX(既定値:15、最大:127)
内部ファイルの固定領域に保存する VARCHAR データの最大長を指定します。
列プロパティ
列の属性を指定します。
| プロパティ名 | 使用できるテーブルの種類 |
|---|---|
| PART_PAGE_COUNT | LOG |
| PAGE_VALUE_COUNT | LOG |
| MAX_CACHE_PART_COUNT | LOG |
| MINMAX_CACHE_SIZE | LOG |
PART_PAGE_COUNT
1 つのパーティションが持つページ数です。1 つのパーティションが持つ値の数は PART_PAGE_COUNT * PAGE_VALUE_COUNT です。
PAGE_VALUE_COUNT
1 つのページが持つ値の数です。
MAX_CACHE_PART_COUNT(既定値:0)
性能向上のためのキャッシュ領域を設定します。
Machbase はパーティションにアクセスする際、そのパーティションのメタ情報を保持するメモリ上の構造体を先に探します。このプロパティは、メモリに保持するパーティション情報の数を指定します。値が大きいほど性能向上に役立ちますが、メモリ使用量が増えます。最小値は 1、最大値は 65535 です。
MINMAX_CACHE_SIZE(既定値:10240)
列の MINMAX に使用するキャッシュメモリの量を指定します。0 番目の隠し列 _ARRIVAL_TIME は既定で 100MB、他の列は既定で 10KB です。このサイズは、テーブル作成後も “ALTER TABLE MODIFY” 文で変更できます。
NOT NULL 制約
NULL を許可しない列には NOT NULL を指定し、許可する場合(既定)は省略します。
テーブル作成後にこの制約を追加または削除するには、ALTER TABLE MODIFY COLUMN を使用します。
-- c1 に NOT NULL を指定し、c2 には指定しない
CREATE TABLE t1(c1 INTEGER NOT NULL, c2 VARCHAR(200));
システム定義列
CREATE TABLE 文でテーブルを作成すると、システムは _ARRIVAL_TIME と _RID の 2 つのシステム定義列を追加で作成します。
_ARRIVAL_TIME は DATETIME 型の列で、INSERT 文や AppendData でデータを入力した時点のシステム時刻が保存されます。この値は、生成されたレコードの一意キーとして使用できます。古い時刻から新しい時刻への順序が保証される場合は、machloader や INSERT 文で値を指定して入力できます。DURATION 条件で検索すると、この列の値を基準にデータを検索します。
_RID は、システムが各レコードに生成する一意の値です。データ型は 64 ビット整数です。ユーザーはこの列に値を指定できず、インデックスも作成できません。値はデータの INSERT 時に自動で生成されます。_RID 列の値でレコードを検索できます。
create volatile table t1111 (i1 integer);
Created successfully.
Mach> desc t1111;

----------------------------------------------------------------
NAME                          TYPE                LENGTH
----------------------------------------------------------------
_ARRIVAL_TIME                 datetime            8
I1                            integer             4

Mach>insert into t1111 values (1);
1 row(s) inserted.
Mach>select _rid from t1111;
_rid
-----------------------
0
[1] row(s) inserted.

Mach>select i1 from t1111 where _rid = 0;
i1
--------------
1
[1] row(s) selected.
Min-Max キャッシュ
Min-Max キャッシュの概念
一般的なディスク DBMS では、インデックスで特定の値を検索すると、インデックスを含むディスク領域にアクセスしてから、その値を含む最終的なディスクページを読み取ります。
一方、Machbase は時系列情報を保持するためにデータを時刻順にパーティション分割するため、1 つのインデックスの情報も時刻順に複数のファイルに分かれています。そのため、Machbase のインデックスを使用すると、パーティションごとに分かれたインデックスファイルを順に検索します。
検索対象のデータが 1000 個のパーティションに分かれている場合、毎回 1000 個のファイルを開いて検索する必要があります。効率的な列指向の構造であっても、この I/O コストはインデックスのパーティション数に比例するため、MINMAX_CACHE 構造で性能を改善します。
MINMAX_CACHE は、各パーティションのインデックスファイル情報、つまり列の最小値と最大値をメモリに保持する連続したメモリ領域です。特定の値を含むパーティションを検索するとき、その値がパーティションの最小値より小さいか最大値より大きければ、そのパーティション全体を読み飛ばせるため、高性能なデータ分析が可能になります。
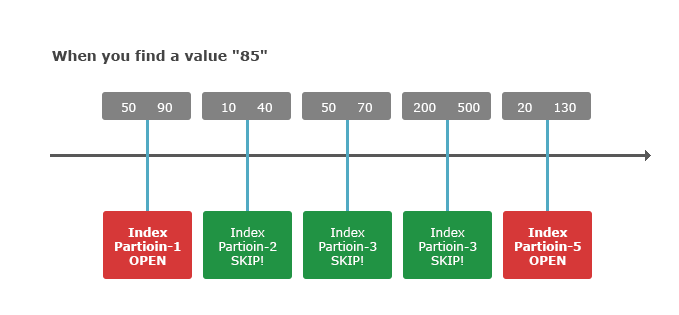
上の図のように、85 を検索する場合は、5 つのパーティションのうち MIN/MAX の範囲に値を含む 1 番と 5 番だけを実際に検索し、2、3、4 番は読み飛ばします。
Min-Max キャッシュ列
テーブル作成時に、列ごとに MINMAX キャッシュを使用するかどうかを指定できます。
列の MINMAX_CACHE_SIZE が 0 以外に設定されていれば、その列のインデックス検索で MINMAX キャッシュが動作し、MINMAX_CACHE_SIZE = 0 なら動作しません。
MINMAX キャッシュを使用する場合は、次の点に注意してください。
- 列にインデックスを明示的に作成しなくても、MINMAX キャッシュは適用されます。
- すべての列の MINMAX_CACHE_SIZE は既定で 10KB です。ALTER TABLE 文で適切なメモリサイズに変更できます。
- 隠し列の _arrival_time は既定で 100MB で、MINMAX キャッシュメモリを自動的に使用します。
- VARCHAR 型は MINMAX キャッシュの対象外です。そのため、VARCHAR 型の列にキャッシュの使用を明示的に指定するとエラーになります。
- テーブルを 1 つ作成するごとに、プロパティに設定した MINMAX_CACHE_SIZE 分のメモリを最大で追加使用できます。メモリはパーティション数の増加に応じて段階的に増え、この最大量まで増加します。
- テーブルにレコードが 1 件もない場合、MINMAX キャッシュメモリはまったく確保されません。
次は、MINMAX キャッシュを設定してテーブルを作成する例です。
-- VARCHAR に MINMAX_CACHE_SIZE=0 を指定することは可能
CREATE TABLE ctest (id INTEGER, name VARCHAR(100) PROPERTY(MINMAX_CACHE_SIZE = 0));
Created successfully.
Mach>

-- id 列にキャッシュを適用
CREATE TABLE ctest2 (id INTEGER PROPERTY(MINMAX_CACHE_SIZE = 10240), name VARCHAR(100) PROPERTY(MINMAX_CACHE_SIZE = 0));
Created successfully.
Mach>

-- id1、id2、id3 に適用
CREATE TABLE ctest3 (id1 INTEGER PROPERTY(MINMAX_CACHE_SIZE = 10240), name VARCHAR(100) PROPERTY(MINMAX_CACHE_SIZE = 0), id2 LONG PROPERTY(MINMAX_CACHE_SIZE = 1024), id3 IPV4 PROPERTY(MINMAX_CACHE_SIZE = 1024), id4 SHORT);
Created successfully.
Mach>

-- 列単位で MINMAX_CACHE_SIZE を指定、または 0 で無効化
CREATE TABLE ctest4 (id1 INTEGER PROPERTY(MINMAX_CACHE_SIZE=10240), name VARCHAR(100) PROPERTY(MINMAX_CACHE_SIZE=0), id2 LONG PROPERTY(MINMAX_CACHE_SIZE=10240), id3 IPV4 PROPERTY(MINMAX_CACHE_SIZE=0), id4 SHORT);
Created successfully.
Mach>
主キー
Volatile/Lookup テーブルの列に設定できる制約で、列値の重複を防ぎます。Lookup テーブルには主キーが必須です。Volatile テーブルでは省略できますが、INSERT ... ON DUPLICATE KEY UPDATE は、対象テーブルに主キーがある場合にのみ使用できます。
主キーを設定すると、主キーに対応する RED-BLACK ツリーインデックスが作成されます。
シーケンス列
Lookup テーブルの SEQUENCE
Lookup テーブルで一意のレコードを生成し、データの入力順序を決めるために、シーケンスが追加されました。
Lookup テーブルで datetime 列を使ってレコードの順序を区別すると、日時が重複した場合に順序を区別しにくく、データの重複によってアプリケーションエラーが発生することがあります。シーケンスは、こうした問題を解決するために追加されました。
Lookup テーブル作成時のシーケンス設定
CREATE TABLE 文で Lookup テーブルを作成するときに、シーケンスとして使用する列へ PROPERTY 句を追加します。
シーケンス列は LONG 型(64 ビット、符号なし)だけをサポートします。
シーケンスの開始値も指定できます。1 を指定すると、シーケンスは 1 から開始します(0 と負数はサポートしません)。
CREATE LOOKUP TABLE table_name (v1 LONG PROPERTY(SEQUENCE=1) PRIMARY KEY, v2 VARCHAR(10));シーケンス列の使用
Lookup テーブルのシーケンス列は、通常の LONG 列と同じように使用できます。この場合、シーケンス値は自動的には増加しません。
シーケンス列には値を直接入力でき、重複する値も入力できます。
シーケンス機能を使用するには、新しく追加されたシーケンス専用関数 nextval でシーケンス値を増加させます。
内部でシーケンス列の最大値を保持しているため、その後 nextval 関数で入力すると、シーケンス列の最大値 + 1 が格納されます。
シーケンス列の例
-- シーケンス列に nextval で次の値を挿入
INSERT INTO table_name (v1, v2) values (nextval(v1), 'aaaa');

-- シーケンス列に直接値を挿入
INSERT INTO table_name (v1, v2) values (100, 'aaaa');

-- シーケンス列に計算値を挿入
INSERT INTO table_name (v1, v2) values (100 + 1, 'aaaa');

-- シーケンス列を持つ Lookup の正常な検索
SELECT v1, v2 FROM table_name;

-- 不正な検索:nextval は INSERT 専用
SELECT nextval(v1), v2 FROM table_name;
CREATE VIEW / DROP VIEW
VIEW は、SELECT の定義を名前付きの論理オブジェクトとして保存し、再利用する機能です。テーブルと異なりデータは別に保存せず、検索時に保存された定義 SQL を展開して実行します。
CREATE VIEW v_example AS
SELECT id, name
FROM t1;

DROP VIEW v_example;
CREATE OR REPLACE VIEW、DROP VIEW IF EXISTS、SHOW VIEWS、M$SYS_VIEWS、性能と制限、Tag/BINARY の例を含む詳しい説明は、VIEW を参照してください。
DROP TABLE
drop_table_stmt:
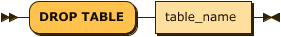
drop_table_stmt ::= 'DROP TABLE' table_name指定したテーブルを削除します。ただし、他のセッションがそのテーブルを検索中の場合は、エラーで失敗します。
-- Example
DROP TABLE TableName;
CREATE TABLESPACE
create_tablespace_stmt:

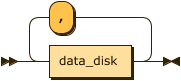
datadisk_list:
data_disk:
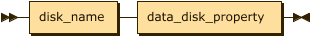
data_disk_property:

create_tablespace_stmt ::= 'CREATE TABLESPACE' tablespace_name 'DATADISK' datadisk_list
datadisk_list ::= data_disk ( ',' data_disk )*
data_disk ::= disk_name data_disk_property
data_disk_property ::= '(' 'DISK_PATH' '=' '"' path '"' ( ',' 'PARALLEL_IO' '=' number )? ')'
-- 例
create tablespace tbs1 datadisk disk1 (disk_path=""); -- $MACHBASE_HOME/dbs/(この場所に作成)
create tablespace tbs1 datadisk disk1 (disk_path="tbs1_disk1"); -- $MACHBASE_HOME/dbs/tbs1_disk1(この場所に作成。tbs1_disk1 は事前作成が必要)
create tablespace tbs2 datadisk disk1 (disk_path="tbs2_disk1", parallel_io = 5);
create tablespace tbs1 datadisk disk1 (disk_path="tbs1_disk1", parallel_io = 10), disk2 (disk_path="tbs1_disk2"), disk3 (disk_path="tbs1_disk3");CREATE TABLESPACE 文は、Log テーブルやそのインデックスを保存するテーブルスペースを $MACHBASE_HOME/dbs/ に作成します。
テーブルスペースは複数のディスクを持てます。テーブルとインデックスのデータを保存する各パーティションファイルは、テーブルスペースに属するデータディスクに分散して保存されます。
2 台以上のディスクを使用すると、インデックスとテーブルのファイルが各ディスクに分散して保存され、各デバイスで I/O が並列に実行されます。ディスクの台数が増えるほどディスク I/O スループットが向上し、大量のデータを高速にディスクへ保存できます。
また、テーブルとインデックスに別々のテーブルスペースを作成して異なるディスクを定義すると、物理ディスクを再構成せずに、テーブルとインデックスの I/O を論理的に分離できます。
DATA DISK
テーブルスペースに属するディスクを定義します。各ディスクには、次の属性があります。
| 属性 | 説明 |
|---|---|
| data_disk_property | ディスクの属性を指定します。 |
| disk_name | ディスクオブジェクトの名前を指定します。後で ALTER TABLESPACE 文でディスクオブジェクトの属性を変更するときに使用します。 |
| disk_path | ディスクのディレクトリパスを指定します。このディレクトリは事前に作成しておく必要があります。相対パスを指定すると、$MACHBASE_HOME/dbs を基準に PATH を探します。例えば PATH = ‘disk1’ の場合、ディスクパスは $MACHBASE_HOME/dbs/disk1 と認識されます。 |
| parallel_io | ディスク I/O 要求を並列でいくつまで許可するかを指定します。(DEF: 3, MIN: 1, MAX: 128) |
DROP TABLESPACE
drop_tablespace_stmt:
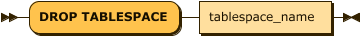
drop_table_stmt ::= 'DROP TABLESPACE' tablespace_name指定したテーブルスペースを削除します。ただし、テーブルスペースに作成されたオブジェクトが残っている場合は、削除に失敗します。
-- Example
DROP TABLESPACE TablespaceName;
CREATE INDEX
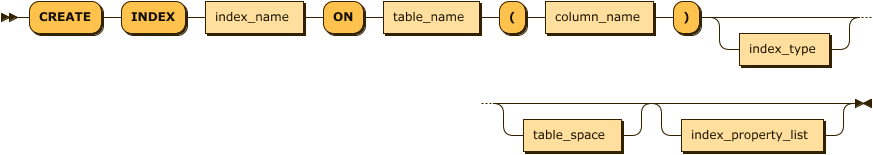
create_index_stmt:
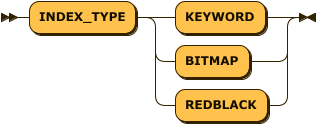
index_type:
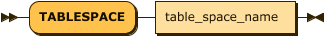
table_space:
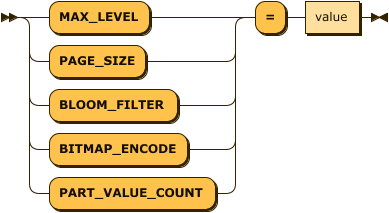
index_property_list:
create_index_stmt ::= 'CREATE' 'INDEX' index_name 'ON' table_name '(' column_name ')' index_type? table_space? index_property_list?
index_type ::= 'INDEX_TYPE' ( 'LSM' | 'KEYWORD' | 'BITMAP' | 'REDBLACK' )
table_space ::= 'TABLESPACE' table_space_name
index_property_list ::= ( 'MAX_LEVEL' | 'PAGE_SIZE' | 'BITMAP_ENCODE' | 'PART_VALUE_COUNT' ) '=' value
インデックスの種類
作成するインデックスの種類を指定します。キーワードインデックス以外で種類を指定しない場合は、テーブルの種類に応じた既定のインデックスの種類で作成されます。
| テーブルの種類 | 既定のインデックスの種類 |
|---|---|
| Volatile テーブル | REDBLACK |
| Lookup テーブル | REDBLACK |
| Log テーブル | LSM |
KEYWORD インデックス
テキスト検索用のインデックスです。Log テーブルの VARCHAR 列と TEXT 列にだけ作成でき、単一列に対してのみ作成できます。
LSM インデックス
LSM(Log Structure Merge)インデックスは、ビッグデータの保存と検索に最適化したインデックスです。LSM インデックスのパーティションはレベルごとに管理され、下位レベルのパーティションがマージされて上位レベルへ移動します。上位レベルのパーティションの作成に使用された下位パーティションは削除されます。
このレベルごとのパーティション構築は、バックグラウンドスレッドが行います。上位レベルのパーティションは下位レベルのパーティションをマージして 1 つにまとめたものなので、インデックス検索には次の利点があります。
- 重複するキーは 1 度だけ保存されるため、キーの保存に必要なディスク領域を節約できます。
- 複数のパーティションではなく 1 つのインデックスパーティションを検索するため、ファイルを開閉するコストが減り、アクセスするインデックスページの数も減ります。
LSM インデックスのプロパティ
| 項目 | 説明 |
|---|---|
| MAX_LEVEL (既定値 3、最小 0、最大 3) | LSM インデックスの最大レベルで、現在は 3 が最大値です。1 つのパーティションの最大レコード数は 2 億件を超えられません。各レベルのパーティションサイズは、前のレベルのパーティションの値の数 * 10 です。例えば MAX_LEVEL = 3、PART_VALUE_COUNT が 100,000 の場合、Level 0 = 100,000、Level 1 = 1,000,000、Level 2 = 10,000,000、Level 3 = 100,000,000 です。最後のレベルのパーティションサイズが 2 億件を超えると、インデックスの作成に失敗します。 |
| PAGE_SIZE (既定値 512 * 1024、最小 32 * 1024、最大 1 * 1024 * 1024) | インデックスのキー値とビットマップ値を保存するページのサイズを指定します。既定値は 512K です。 |
| BITMAP_ENCODE (既定値 EQUAL、選択肢 RANGE) | インデックスのビットマップの種類を設定します。 BITMAP_ENCODE = EQUAL(既定値)はキー値と同じ値のビットマップを作成し、BITMAP = RANGE はキー値の範囲に応じたビットマップを作成します。 主に = を検索条件に使用する場合は BITMAP_ENCODE = EQUAL、主に特定の範囲を検索条件に使用する場合は BITMAP_ENCODE = RANGE に設定することを推奨します。 BITMAP = RANGE の場合、作成コストは EQUAL よりやや高くなります。 |
BITMAP インデックス
データ分析用のインデックスで、Log テーブルにだけ作成できます。VARCHAR、TEXT、BINARY 以外のすべての列に作成でき、単一列に対してのみ作成できます。
RED-BLACK インデックス
リアルタイムのデータ検索用のメモリインデックスで、Volatile/Lookup テーブルにだけ作成できます。これらのテーブルのすべての列に作成でき、単一列に対してのみ作成できます。
インデックスプロパティ
LSM インデックスには、次のプロパティを指定できます。
PART_VALUE_COUNT
インデックスの 1 つのパーティションに保存される行数です。
-- 例
-- c1 にインデックスを適用
CREATE INDEX index1 on table1 ( c1 );
-- LSM を明示的に適用
CREATE INDEX index_lsm on table1 ( c1 ) INDEX_TYPE LSM;
-- VARCHAR の var_column に KEYWORD を作成。page_size は 100000
CREATE INDEX index2 on table1 (var_column) INDEX_TYPE KEYWORD PAGE_SIZE=100000;
JSON パスインデックス
JSON 列のメンバーにインデックスを作成する場合は、従来の JSONPath 矢印構文と JSON ドット省略記法の両方を使用できます。
CREATE TAG TABLE tag_log (
    name  VARCHAR(40) PRIMARY KEY,
    time  DATETIME BASETIME,
    value JSON
);

-- JSON のドット省略記法
CREATE INDEX tag_log_sensor_idx ON tag_log (value.sensor.name);

-- 従来の JSONPath 矢印構文
CREATE INDEX tag_log_metric_idx ON tag_log (value->'$.metric');

-- 配列添字と二重引用符のキー
CREATE INDEX tag_log_item_idx ON tag_log (value.items[0]."product-id");
JSON 列名を二重引用符で囲んで作成した場合や、キーワードを列名に使用した場合も、従来の矢印構文の DDL を使用できます。
CREATE TAG TABLE tag_log_q (
    name    VARCHAR(40) PRIMARY KEY,
    time    DATETIME BASETIME,
    "value" JSON
);

CREATE INDEX tag_log_q_idx ON tag_log_q ("value"->'$.sensor.name');

CREATE TAG TABLE tag_log_kw (
    name   VARCHAR(40) PRIMARY KEY,
    time   DATETIME BASETIME,
    "LEFT" JSON
);

CREATE INDEX tag_log_kw_idx ON tag_log_kw (left->'$.sensor.name');
文字列の比較条件には JSON パスインデックスを使用できます。数値や真偽値の意味を持つ比較条件は、文字列の順序と数値の順序が異なる場合があるため、JSON パスインデックスの範囲条件には使用しません。
TAGDATA メタデータの JSON パスインデックスについては、Tag メタデータとTag テーブルのインデックスを参照してください。
DROP INDEX
drop_index_stmt:
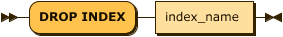
drop_index_stmt ::= 'DROP INDEX' index_name指定したインデックスを削除します。ただし、他のセッションがそのテーブルを検索中の場合は、エラーで失敗します。
-- Example
DROP INDEX IndexName;
ALTER TABLE
ALTER TABLE 文は、指定したテーブルのスキーマ情報を変更するときに使用します。
- ほとんどの
ALTER TABLE操作は Log テーブルでのみ使用できます。 - RENAME COLUMN 操作は Log テーブルと Tag テーブルの両方で使用できます。
ALTER TABLE SET
テーブルのプロパティを変更する構文です。現在、動的に変更できるプロパティはありません。
ALTER TABLE ADD COLUMN
alter_table_add_stmt:

alter_table_add_stmt ::= 'ALTER TABLE' table_name 'ADD COLUMN' '(' column_name column_type ( 'DEFAULT' value )? ')'テーブルに列をリアルタイムで追加します。列の名前と型を指定し、DEFAULT 句で既定のデータ値を設定できます。
-- Example-1
alter table atest2 add column (id4 float);

-- Example-2
alter table atest2 add column (id6 double  default 5);
alter table atest2 add column (id7 ipv4  default '192.168.0.1');
alter table atest2 add column (id8 varchar(4) default 'hello');
ALTER TABLE DROP COLUMN
alter_table_drop_stmt:

alter_table_drop_stmt ::= 'ALTER TABLE' table_name 'DROP COLUMN' '(' column_name ')'テーブルの特定の列をリアルタイムで削除します。
-- Example
alter table atest2 drop column (id4);
alter table atest2 drop column (id8);
ALTER TABLE METADATA ADD COLUMN
alter_table_metadata_add_stmt:
alter_table_metadata_add_stmt ::= 'ALTER TABLE' table_name 'METADATA ADD COLUMN' '(' column_name column_type ( 'DEFAULT' value )? ')'TAG テーブルにメタデータ列を追加します。メタデータ列には、データポイントごとに頻繁には変わらないタグ固有の情報を保存します。
注意:この操作は TAG テーブルでのみ使用できます。
-- 例:TAG にメタデータ列を追加
ALTER TABLE altertbl METADATA ADD COLUMN (m1 DOUBLE);
ALTER TABLE altertbl METADATA ADD COLUMN (m2 VARCHAR(100));
ALTER TABLE altertbl METADATA ADD COLUMN (m3 INTEGER DEFAULT 0);
ALTER TABLE METADATA DROP COLUMN
alter_table_metadata_drop_stmt:
alter_table_metadata_drop_stmt ::= 'ALTER TABLE' table_name 'METADATA DROP COLUMN' '(' column_name ')'TAG テーブルからメタデータ列を削除します。
注意:この操作は TAG テーブルでのみ使用できます。
-- 例:TAG のメタデータ列を削除
ALTER TABLE altertbl METADATA DROP COLUMN (m1);
ALTER TABLE altertbl METADATA DROP COLUMN (m2);
ALTER TABLE RENAME COLUMN
alter_table_column_rename_stmt:

alter_table_column_rename_stmt ::= 'ALTER TABLE' table_name 'RENAME COLUMN' old_column_name 'TO' new_column_nameテーブルの特定の列名を変更します。この操作は Log テーブルと Tag テーブルの両方で使用できます。
-- Log の例
alter table atest2 rename column id7 to id7_rename;

-- Tag の例
alter table tag rename column v0001 to vmax;注意:Tag テーブルでは、追加の値列に加えて、PRIMARY KEY、BASETIME、METADATA の列を含むすべての列名を変更できます。ただし、Tag テーブルに ROLLUP テーブルが定義されている場合は、列名の変更が制限されることがあります。
注意:Tag テーブルの RENAME COLUMN 操作は Machbase 8.0.50 以降でサポートされます。
ALTER TABLE MODIFY COLUMN
alter_table_modify_stmt:
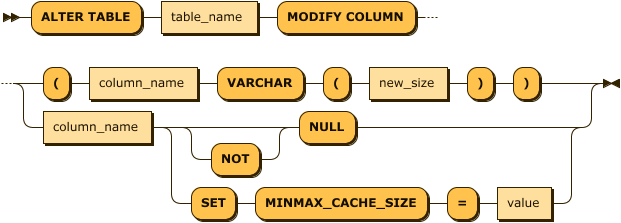
alter_table_modify_stmt ::= 'ALTER TABLE' table_name 'MODIFY COLUMN' ( '(' column_name 'VARCHAR' '(' new_size ')' ')' | column_name ( 'NOT'? 'NULL' | 'SET' 'MINMAX_CACHE_SIZE' '=' value ) )テーブルの特定の列の属性を変更します。現在は、VARCHAR 型の列の長さと、その他の型の列の MINMAX CACHE 属性および NOT NULL 制約を変更できます。
VARCHAR のサイズ
この構文は、VARCHAR 型の列の長さの変更だけをサポートします。既存データを保持するため、長さは短縮できず、常に拡張する必要があります。
ALTER TABLE table_name MODIFY COLUMN (column_name VARCHAR(new_size));-- 例:次のテーブルがある場合
-- create table atest5 (id integer, name varchar(5), id3 double, id4 float);
-- エラー:別の型へ変更できない
alter table atest5 modify column (id varchar(10));
-- エラー:VARCHAR の長さは短縮できない
alter table atest5 modify column (name varchar(3));
-- エラー:VARCHAR の最大サイズは 32767 を超えられない
alter table atest5 modify column (name varchar(32768));
-- 成功
alter table atest5 modify column (name varchar(128));MINMAX_CACHE_SIZE
特定の列の MINMAX_CACHE_SIZE を変更します。
ALTER TABLE table_name MODIFY COLUMN column_name SET MINMAX_CACHE_SIZE=value;-- 例:次のテーブルがある場合
create table atest9 (id integer, name varchar(100));
-- エラー:VARCHAR には適用できない
alter table atest9 modify column name set minmax_cache_size=0;
[ERR-02139 : MINMAX CACHE is not allowed for VARCHAR column(NAME).]
-- 変更成功
alter table atest9 modify column id set minmax_cache_size=10240;NOT NULL
列に NOT NULL 制約を追加します。列にすでに NULL 値がある場合、DDL 操作は失敗します。
列に NULL 値を許可するには、次に説明する MODIFY COLUMN NULL コマンドを使用します。
ALTER TABLE table_name MODIFY COLUMN column_name NOT NULL;-- t1.c1 に NOT NULL を追加
alter table t1 modify column c1 not null;NULL
NOT NULL 制約を解除し、NULL 値を入力できるようにします。この場合、LSM インデックスの min_max キャッシュによる性能改善は得られません。
ALTER TABLE table_name MODIFY COLUMN column_name NULL;-- t1.c1 の NOT NULL を解除
alter table t1 modify column c1 null;ALTER TABLE RENAME TO
alter_table_rename_stmt:

alter_table_rename_stmt ::= 'ALTER TABLE' table_name 'RENAME TO' new_nameテーブル名を変更します。
メタテーブルの名前は変更できず、新しい名前に $ 文字は使用できません。テーブル名を変更できるのは Log テーブルだけです。
-- worker を employee に変更
ALTER TABLE worker RENAME TO employee;
ALTER TABLE ADD RETENTION
alter_table_add_retention_stmt:
alter_table_add_retention_stmt ::= 'ALTER TABLE' table_name 'ADD RETENTION' policy_name
ALTER TABLE tag ADD RETENTION policy_1d_1h;ALTER TABLE DROP RETENTION
alter_table_drop_retention_stmt:
alter_table_drop_retention_stmt ::= 'ALTER TABLE' table_name 'DROP RETENTION'
ALTER TABLE tag DROP RETENTION;ALTER TABLESPACE
ALTER TABLESPACE 文は、指定したテーブルスペースに関する情報を変更するときに使用します。
ALTER TABLESPACE MODIFY DATADISK
この構文は、テーブルスペースに属する DATADISK の属性を変更するときに使用します。
alter_tablespace_stmt:

alter_tablespace_stmt ::= 'ALTER TABLESPACE' table_name 'MODIFY DATADISK' disk_name 'SET' 'PARALLEL_IO' '=' value-- Example
ALTER TABLESPACE tbs1 MODIFY DATADISK disk1 SET PARALLEL_IO = 10;TRUNCATE TABLE
truncate_table_stmt:
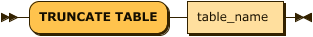
truncate_table_stmt ::= 'TRUNCATE TABLE' table_name-- ctest の全データを削除
Mach> truncate table ctest;
Truncated successfully.指定したテーブルのすべてのデータを削除します。ただし、他のセッションがそのテーブルを検索中の場合は、エラーで失敗します。
CREATE ROLLUP
create_rollup_stmt:
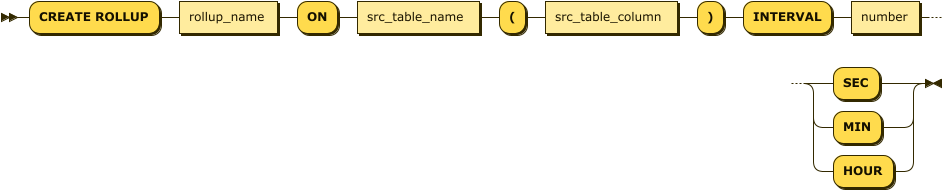
create_rollup_stmt ::= 'CREATE ROLLUP' rollup_name 'ON' src_table_name '('src_table_column')' 'INTERVAL' number ('SEC' | 'MIN' | 'HOUR')-- Tag の value 列を対象とするロールアップを作成
Mach> CREATE ROLLUP _rollup_tag_value_sec ON tag(value) INTERVAL 1 SEC;
Executed successfullyJSON 列のメンバーをロールアップの対象値にする場合は、従来の JSONPath 矢印構文と JSON ドット省略記法の両方を使用できます。
CREATE TAG TABLE tag_json (
    name  VARCHAR(40) PRIMARY KEY,
    time  DATETIME BASETIME,
    value JSON
);

-- JSON のドット省略記法
CREATE ROLLUP tag_json_metric_ru
ON tag_json (value.metric)
INTERVAL 1 SEC;

-- 従来の JSONPath 矢印構文
CREATE ROLLUP tag_json_metric_arrow_ru
ON tag_json (value->'$.metric')
INTERVAL 1 SEC;

-- 配列添字と二重引用符のキー
CREATE ROLLUP tag_json_item_ru
ON tag_json (value.items[0]."metric-id")
INTERVAL 1 SEC;
引用符で囲んだ列名やキーワードの列名も、従来の矢印構文で引き続き使用できます。
CREATE TAG TABLE tag_json_q (
    name    VARCHAR(40) PRIMARY KEY,
    time    DATETIME BASETIME,
    "value" JSON
);

CREATE ROLLUP tag_json_q_ru
ON tag_json_q ("value"->'$.metric')
INTERVAL 1 SEC;

CREATE TAG TABLE tag_json_kw (
    name   VARCHAR(40) PRIMARY KEY,
    time   DATETIME BASETIME,
    "LEFT" JSON
);

CREATE ROLLUP tag_json_kw_ru
ON tag_json_kw (left->'$.metric')
INTERVAL 1 SEC;元データを修正したために既存のロールアップ結果を再作成する必要がある場合は、ロールアップの再構築を参照してください。
create_conditional_rollup_stmt ::= 'CREATE ROLLUP' rollup_name
                                   ( 'ON' src_table_name '('src_table_column')'
                                   | 'FROM' src_rollup_table_name )
                                   'INTERVAL' number ('SEC' | 'MIN' | 'HOUR')
                                   'WHERE' predicate
-- 条件付き:value2=0 の行だけを集計
Mach> CREATE ROLLUP _rollup_tag_value_min_ok
ON tag(value)
INTERVAL 1 MIN
WHERE value2 = 0;
Executed successfullycreate_custom_rollup_stmt ::= 'CREATE ROLLUP' rollup_name
'INTO' '(' dest_table_name ')'
'AS' '(' select_stmt ')'
'INTERVAL' number ('SEC' | 'MIN' | 'HOUR')
[ 'WAKEUP INTERVAL' number ('SEC' | 'MIN' | 'HOUR') ]-- ユーザー定義集計を TAG に保存するカスタムロールアップ
Mach> CREATE ROLLUP rollup_stock_1m
INTO (stock_rollup_1m)
AS (
SELECT code,
DATE_TRUNC('minute', time) AS time,
SUM(price) AS sum_price,
COUNT(*) AS cnt
FROM stock_tick
GROUP BY code, time
)
INTERVAL 1 MIN;
Executed successfully注意事項
- 条件付きロールアップの
WHEREは、ON/FROM形式のロールアップ構文で使用します。 - カスタムロールアップでは、
WHEREはSELECT内でのみ使用します。 - 外側の
INTERVAL ... WHERE ...は、カスタムロールアップの構文ではサポートされません。 - 制約とクエリーパターンの詳細は、カスタムロールアップ:ユーザー定義集計を参照してください。
DROP ROLLUP
drop_rollup_stmt:
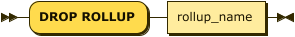
drop_rollup_stmt ::= 'DROP ROLLUP' rollup_name-- ロールアップを削除
Mach> DROP ROLLUP _rollup_tag_value_sec;
Executed successfullyALTER ROLLUP
ロールアップワーカーと、その起動間隔を制御します。
alter_rollup_start_stop_stmt ::= 'ALTER ROLLUP' rollup_name ( 'START' | 'STOP' )
alter_rollup_force_stmt      ::= 'ALTER ROLLUP' rollup_name 'FORCE'
alter_rollup_wakeup_stmt     ::= 'ALTER ROLLUP' rollup_name 'WAKEUP'
alter_rollup_wakeup_int_stmt ::= 'ALTER ROLLUP' rollup_name 'SET WAKEUP INTERVAL' number ( 'SEC' | 'MIN' | 'HOUR' )
例
-- ワーカーを開始、停止
ALTER ROLLUP _rollup_tag_value_sec START;
ALTER ROLLUP _rollup_tag_value_sec STOP;

-- 直ちに起動通知(待機しない)
ALTER ROLLUP _rollup_tag_value_sec WAKEUP;

-- 直ちに実行し、完了を待つ
ALTER ROLLUP _rollup_tag_value_sec FORCE;

-- 起動間隔を短縮(集計間隔を割り切る必要あり)
ALTER ROLLUP _rollup_tag_value_sec SET WAKEUP INTERVAL 1 SEC;
規則
- 起動間隔は 0 より大きく、ロールアップ間隔以下で、ロールアップ間隔を割り切れる値である必要があります。満たさない場合はエラーになります。
WAKEUPはスレッドを起こすだけで、直ちに戻ります。追いつくまで待つ必要がある場合はFORCEを使用します。
CREATE RETENTION
create_retention_stmt:
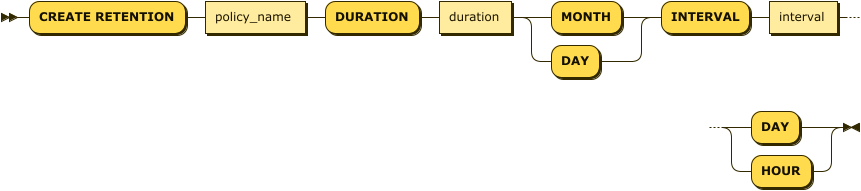
create_retention_stmt ::= 'CREATE RETENTION' policy_name 'DURATION' duration ( 'MONTH' | 'DAY' ) 'INTERVAL' interval ( 'DAY' | 'HOUR' )-- Creates a retention policy.
Mach> CREATE RETENTION policy_1d_1h DURATION 1 DAY INTERVAL 1 HOUR;
Executed successfullyDROP RETENTION
drop_retention_stmt:
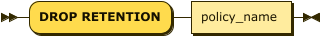
drop_retention_stmt ::= 'DROP RETENTION' policy_name-- Drops the retention policy.
Mach> DROP RETENTION policy_1d_1h;
Executed successfully