GROUP()
構文
GROUP( [lazy(boolean)] [, by()] [, aggregator...] )lazy(boolean):遅延モードを設定します(既定値はfalse)。by(value [, timewindow()] [, name]):指定した値でグループを分ける方法を指定します。 以前はGROUP()でby()が必須でしたが、 Since v8.0.14 以降は省略して、データ全体に一度に集計関数を適用できます。aggregator:集計関数のリスト。複数の集計関数をカンマで区切って指定できます。
| |
結果
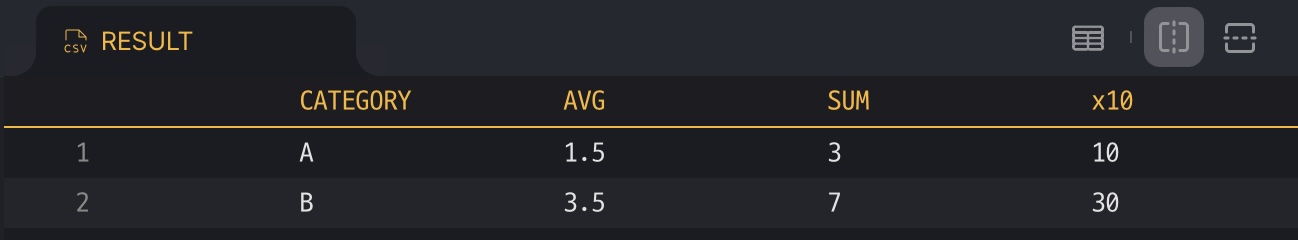
by()
by() は、最初の引数として値を受け取り、省略可能な引数として timewindow() と name を受け取ります。
構文: by( value [, timewindow] [, label] )
value:グループ化の基準値。通常は時刻または文字列です。timewindow(from, until, period):時間範囲を指定します。label:string、新しいカラム名(既定値は"GROUP")。
lazy()
構文: lazy(boolean)
false(既定値)の場合、GROUP() は現在のレコードの by() 値を前のレコードの値と比較し、値が変わるたびに新しいレコードを出力します。
そのため、連続するレコードの by() 値が同じ場合にのみ、1つのグループになります。
lazy(true) を設定すると、レコードを出力する前に入力ストリームの終端まですべてのレコードを蓄積するため、未ソートの by() 値もグループ化できますが、多くのメモリを使用します。
timewindow()
構文: timewindow( from, until, period )
Since v8.0.13
from、until:time、時間範囲です。from は範囲に含まれ、until は含まれません。 実データの有無にかかわらず、必要な時間範囲を指定できます。period:duration、from と until の間を区切る時間間隔です。
timewindowの例を参照してください。
データベースに保存されたデータの分析や可視化は、手間がかかる場合があります。必要な時間範囲にデータがない場合や、1つの区間に複数のデータがある場合は、なおさらです。
たとえば、一定の時間間隔で時刻と値のチャートを表示する場合、SELECT文で取得したデータをそのままチャートライブラリに渡すと、レコード間の時間間隔がチャートの時間軸と揃わないことがあります。途中のデータが欠けていたり、ある区間にデータが密集していたりするとこのようなずれが生じ、必要な形にデータを整えるのが難しくなります。
通常、アプリケーション開発者は一定の時間間隔の配列を作成し、クエリ結果のレコードを順に読みながら配列の各要素(スロット)を埋めます。スロットにすでに値がある場合は、特定の演算(例:min、max、first、last)で1つの値だけを保持します。最後に、値のないスロットを任意の値(例:0またはNULL)で埋めます。
timewindow() を使うと、この処理をTQL内で行えます。
集計関数(aggregator)
集計関数を指定しない場合、GROUP はグループごとに by() の値だけを含むレコードを1件生成します。
たとえば、["A",1]、["A",2]、["B",3] のレコードに GROUP( by(value(0)) ) を適用すると、A と B の2件のレコードが生成され、ほかの値は破棄されます。
グループの値を残すには、list() などの集計関数を指定します。
集計関数
構文: function_name( value [, value...] [, where()] [, nullValue()] [, predict()] [, label])
value:関数に応じて1つ以上の値を渡します。where( predicate ):条件式を受け取り、条件式がtrueになる値だけを集計します。nullValue(alternative):集計結果として出力する値がない場合に、NULLの代わりに使用する値を指定します。predict(algorithm):集計結果として出力する値がない場合に、NULLの代わりに使用する値を予測するアルゴリズムを指定します。label:string、結果のカラム名(既定値は集計関数名)。
集計関数には2種類あります。
- Type 1:結果の候補値だけを保持し、最終値のみを返します。
- Type 2:グループ全体のデータを保持して集計結果を計算した後、次のグループのためにメモリを解放します。
GROUP()でlazy(true)とType 2関数を併用すると、関連カラムの入力データ全体をメモリに保持します。
共通オプション
where()、nullValue()、predict()、label は省略可能な引数で、以下の各関数の構文の option に当たります。
where()
構文: where(predicate)
Since v8.0.13
whereの例を参照してください。
nullValue()
構文: nullValue(alternative)
Since v8.0.13
nullValueの例を参照してください。
predict()
構文: predict(algorithm)
Since v8.0.13
predictの例を参照してください。
| algorithm | 説明 |
|---|---|
PiecewiseConstant | 左連続の区分定数による1次元補間 |
PiecewiseLinear | 1次元の区分線形補間 |
AkimaSpline | 値と1階微分が連続する区分3次の1次元補間。 https://www.iue.tuwien.ac.at/phd/rottinger/node60.html を参照 |
FritschButland | 値と1階微分が連続し、単調性を保証する区分3次の1次元補間。 Fritsch, F. N. and Butland, J., “A method for constructing local monotone piecewise cubic interpolants” (1984), SIAM J. Sci. Statist. Comput., 5(2), pp. 300-304を参照 |
LinearRegression | 隣接値を使った線形回帰による補間 |
関数一覧
以下のType 1関数の x は float 値です。
avg()
Type 1、構文: avg(x [, option...])
グループの値の平均です。
sum()
Type 1、構文: sum(x [, option...])
グループの値の合計です。
count()
Type 1、構文: count(x [, option...])
Since v8.0.13
グループの値の件数です。
first()
Type 1、構文: first(x [, option...])
グループの最初の値です。
last()
Type 1、構文: last(x [, option...])
グループの最後の値です。
min()
Type 1、構文: min(x [, option...])
グループの最小値です。
max()
Type 1、構文: max(x [, option...])
グループの最大値です。
rss()
Type 1、構文: rss(x [, option...])
二乗和平方根(Root Sum Square)
rms()
Type 1、構文: rms(x [, option...])
二乗平均平方根(Root Mean Square)
list()
Type 2、構文: list(x [, option...])
Since v8.0.15
x:float 値
list() は、すべての x 値を集計し、各値を含む1つのリストを生成します。
JSON(rowsArray(true)) や FLATTEN() と組み合わせると、結果をさまざまな形式に加工できます。
| |
{
    "data": {
        "columns": ["GROUP", "LIST"],
        "types": ["string", "list"],
        "rows": [
            ["A", [1,2]],
            ["B", [3,4]],
            ["C", [5]]
        ]
    },
    "success": true,
    "reason": "success",
    "elapse": "220.375µs"
}lrs()
Type 2、構文: lrs(x, y [, weight(w)] [, option...])
Since v8.0.13
x:float または timey:float 値weight(w):省略した場合、すべての重みは1です。
x-y を直交座標系の点とみなし、線形回帰の傾き(Linear Regression Slope)を求めます。x は数値型または時刻型です。
mean()
Type 2、構文: mean(x [, weight(w)] [, option...])
x:float 値weight(w):省略した場合、すべての重みは1です。
mean() は、グループ化した値の加重平均を計算します。すべての重みが1の場合は、性能上、軽量な avg() を使用してください。
mean($x$, weight($w$)) = $ \frac{\sum {w_i x_i}} {\sum {w_i}} $
cdf()
Type 2、構文: cdf(x, q [, weight(w)] [, option...])
Since v8.0.14
x:floatq:floatweight(w):省略した場合、すべての重みは1です。
cdf() は、x の経験累積分布関数の値、すなわちq以下のサンプルの割合を返します。
cdf() は理論上 quantile() の逆関数ですが、すべての q で実際に逆関数になるとは限りません。
correlation()
Type 2、構文: correlation(x, y [, weight(w)] [, option...])
Since v8.0.14
x、y:float 値weight(w):省略した場合、すべての重みは1です。
correlation() は、x と y のサンプル間の加重相関を返します。
correlation($x$, $y$, weight($w$)) = $ \frac{\sum {w_i (x_i - \bar{x}) (y_i - \bar{y})}} {stdX * stdY} $, ($\bar{x}$ = xの平均、$\bar{y}$ = yの平均)
covariance()
Type 2、構文: covariance(x, y [, weight(w)] [, option...])
Since v8.0.14
x、y:float 値weight(w):省略した場合、すべての重みは1です。
covariance() は、x と y のサンプル間の加重共分散を返します。
covariance($x$, $y$, weight($w$)) = $ \frac{\sum {w_i (x_i - \bar{x}) (y_i - \bar{y})}} { \sum {w_i} -1 } $, ($\bar{x}$ = xの平均、$\bar{y}$ = yの平均)
quantile()
Type 2、構文: quantile(x, p [, weight(w)] [, option...])
Since v8.0.13
x:float 値p:float、割合weight(w):省略した場合、すべての重みは1です。
quantile() は、サンプルの割合p以上を下側に含むxのサンプル値を返します。pは0から1の範囲で指定します。
サンプルの割合p以上を下側に含む、最小の値qを返します。
quantileInterpolated()
Type 2、構文: quantileInterpolated(x, p [, weight(w)] [, option...])
Since v8.0.13
x:float 値p:float、割合weight(w):省略した場合、すべての重みは1です。
quantile() は、サンプルの割合p以上を下側に含むxのサンプル値を返します。pは0から1の範囲で指定します。
quantileInterpolated() の戻り値は、線形補間した値です。
median()
Type 2、構文: median(x [, weight(w)] [, option...])
x:float 値weight(w):省略した場合、すべての重みは1です。
quantile(x, 0.5 [, option...]) と同じです。
medianInterpolated()
Type 2、構文: medianInterpolated(x [, weight(w)] [, option...])
x:float 値weight(w):省略した場合、すべての重みは1です。
quantileInterpolated(x, 0.5 [, option...]) と同じです。
stddev()
Type 2、構文: stddev(x [, weight(w)] [, option...])
weight(w):省略した場合、すべての重みは1です。
stddev() は、標本標準偏差を返します。
stderr()
Type 2、構文: stderr(x [, weight(w)] [, option...])
weight(w):省略した場合、すべての重みは1です。
stderr() は、指定した値の標準偏差を用いて平均の標準誤差を返します。
entropy()
Type 2、構文: entropy(x [, option...])
分布のシャノンエントロピーです。自然対数を使用します。
mode()
Type 2、構文: mode(x [, weight(w)] [, option...])
weight(w):省略した場合、すべての重みは1です。
mode() は、value で指定したデータと重みに基づき、データセットで最も頻出する値を返します。
値の比較にはfloat64の厳密な等価比較を使用するため、注意してください。
最頻値が複数ある場合、いずれか1つを返します。
moment()
Type 2、構文: moment(x, n [, weight(w)] [, option...])
Since v8.0.14
x:float64、値n:float64、モーメントの次数weight(w):省略した場合、すべての重みは1です。
moment() は、サンプルの加重 n 次モーメントを計算します。
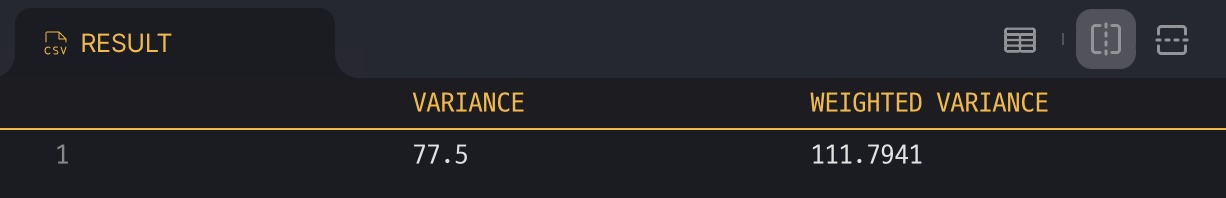
variance()
Type 2、構文: variance(x [, weight(w)] [, option...])
Since v8.0.14
x:float 値weight(w):省略した場合、すべての重みは1です。
variance() は、グループ化した値の不偏加重分散を計算します。
重みの合計が1以下の場合は、偏りのある分散推定量を使用する必要があります。
| |
例
timewindow()
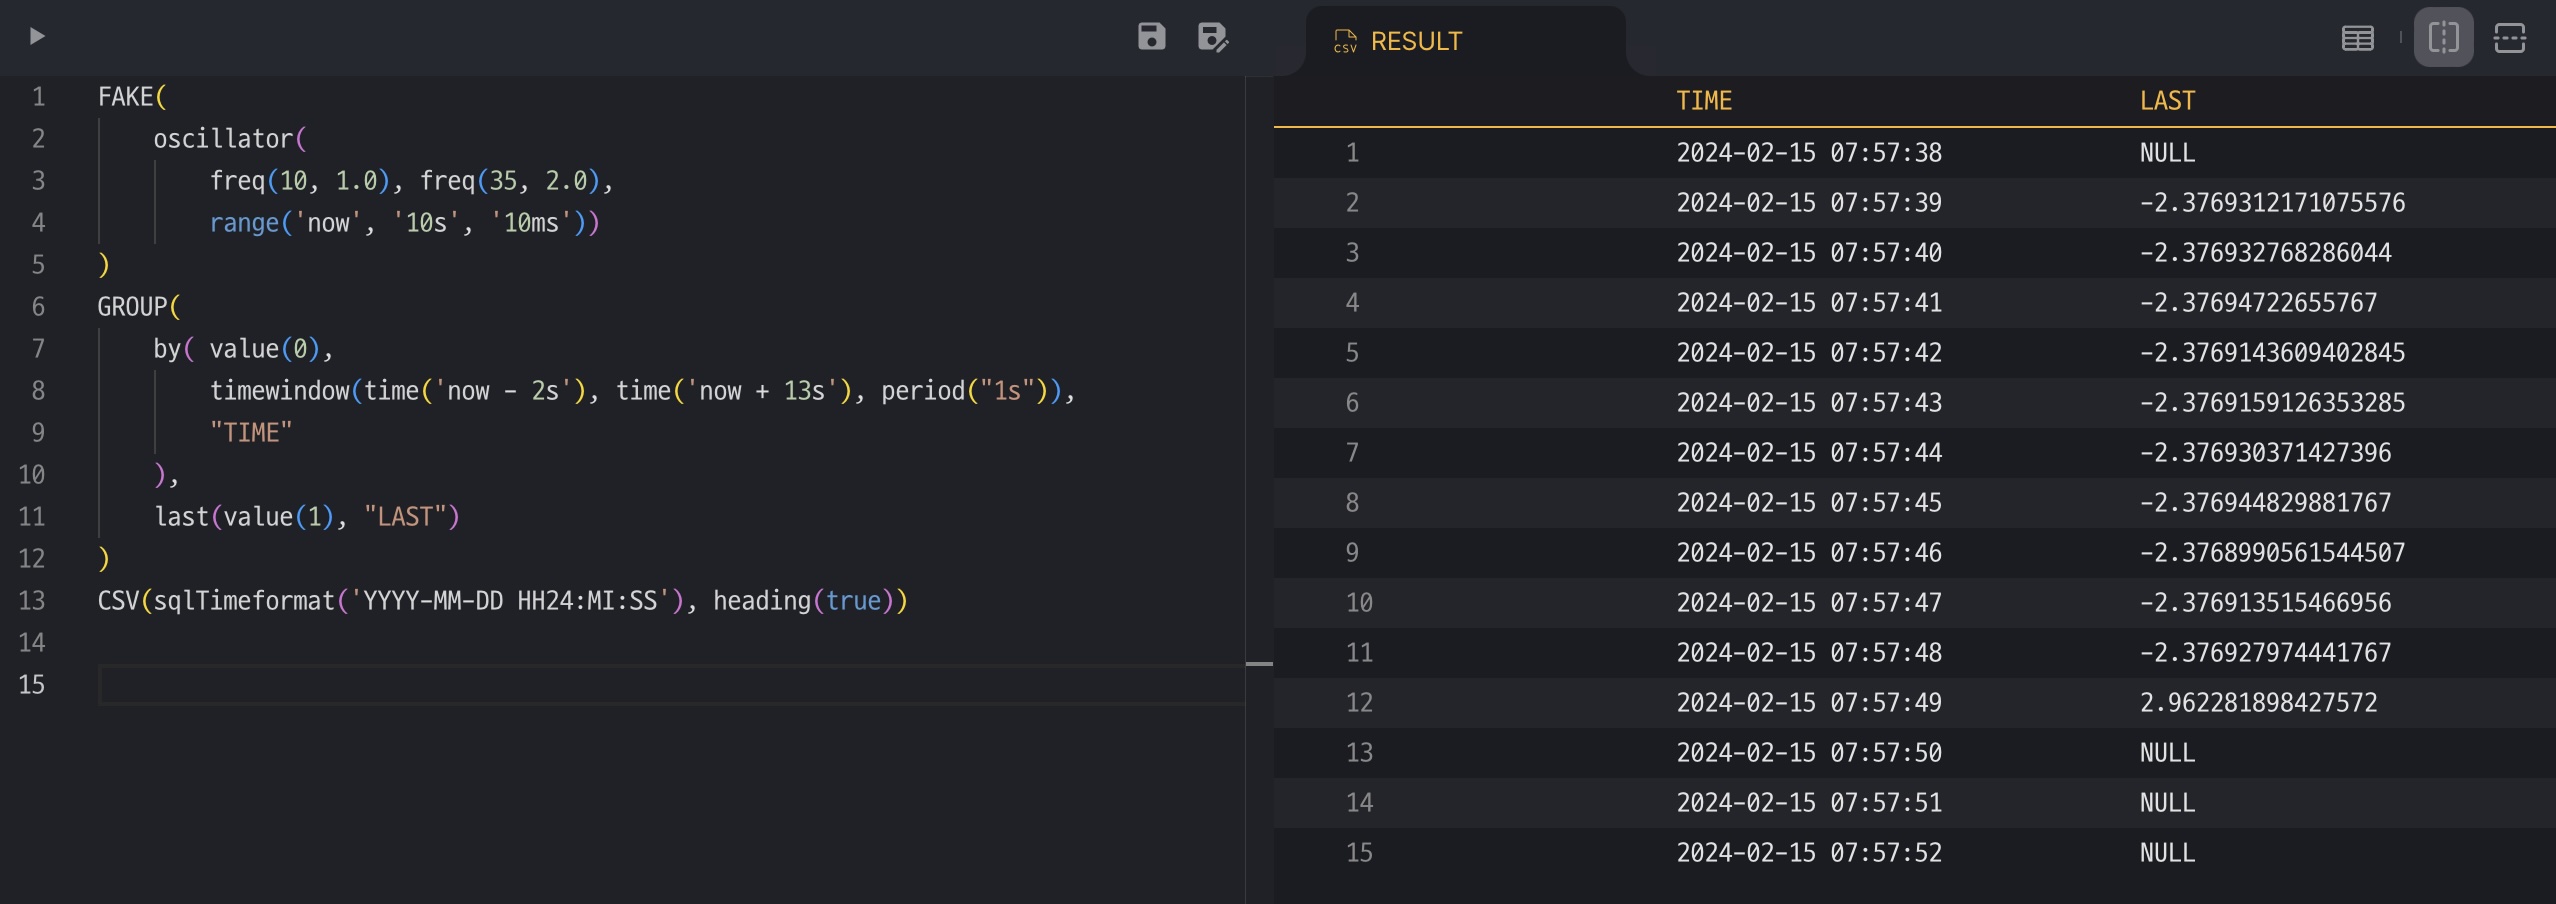
FAKE() は10msごとに時刻と値のレコードを生成するため、1秒間に100レコードがあります。
以下のTQLは、1秒間隔(timewindow() の period("1s"))のデータを生成します。
必要な時間帯に実データ(レコード)がなければ、既定値のNULLで埋めます。
| |
nullValue()
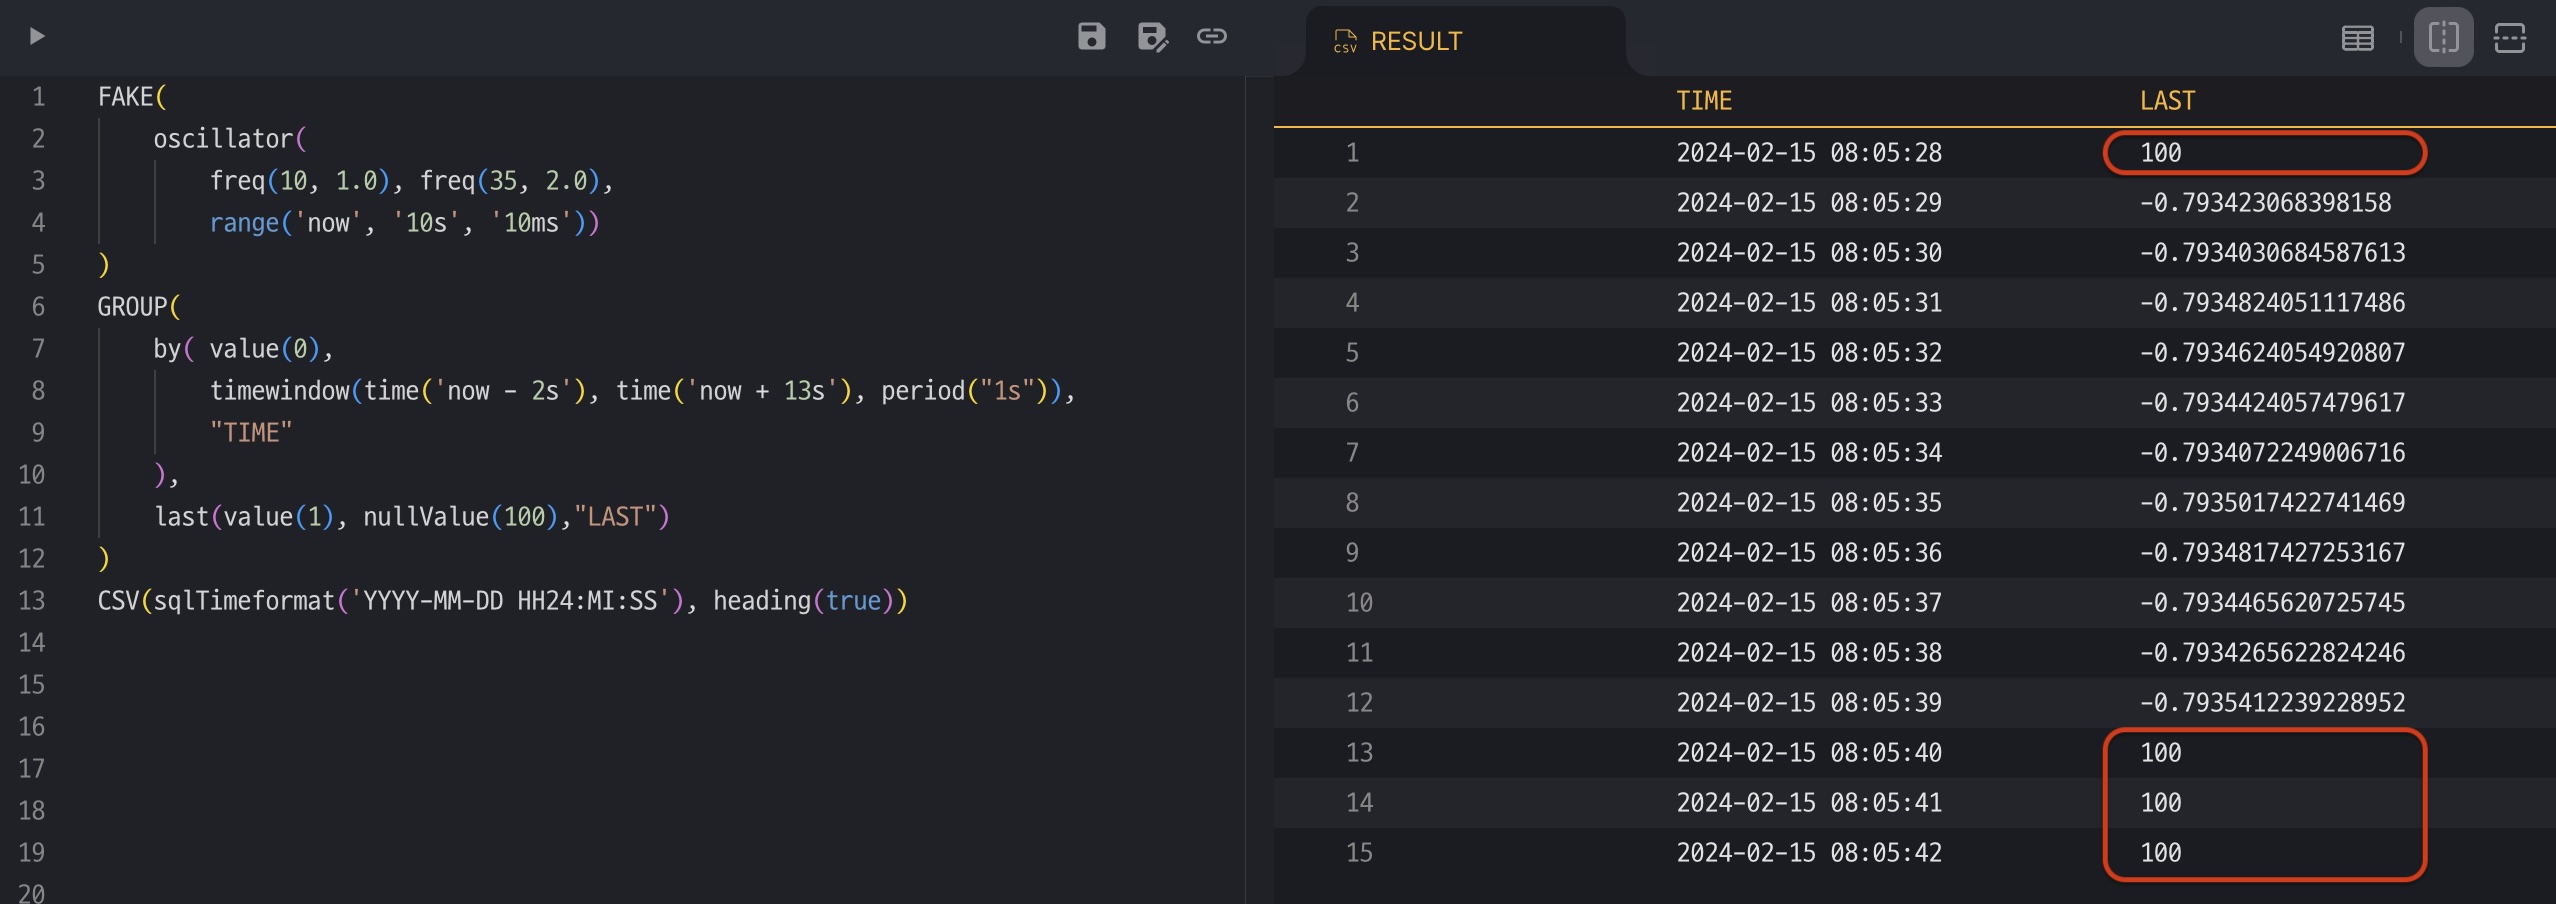
nullValue(100) を追加して再実行します。NULL値が指定した100に置き換わります。
| |
predict()
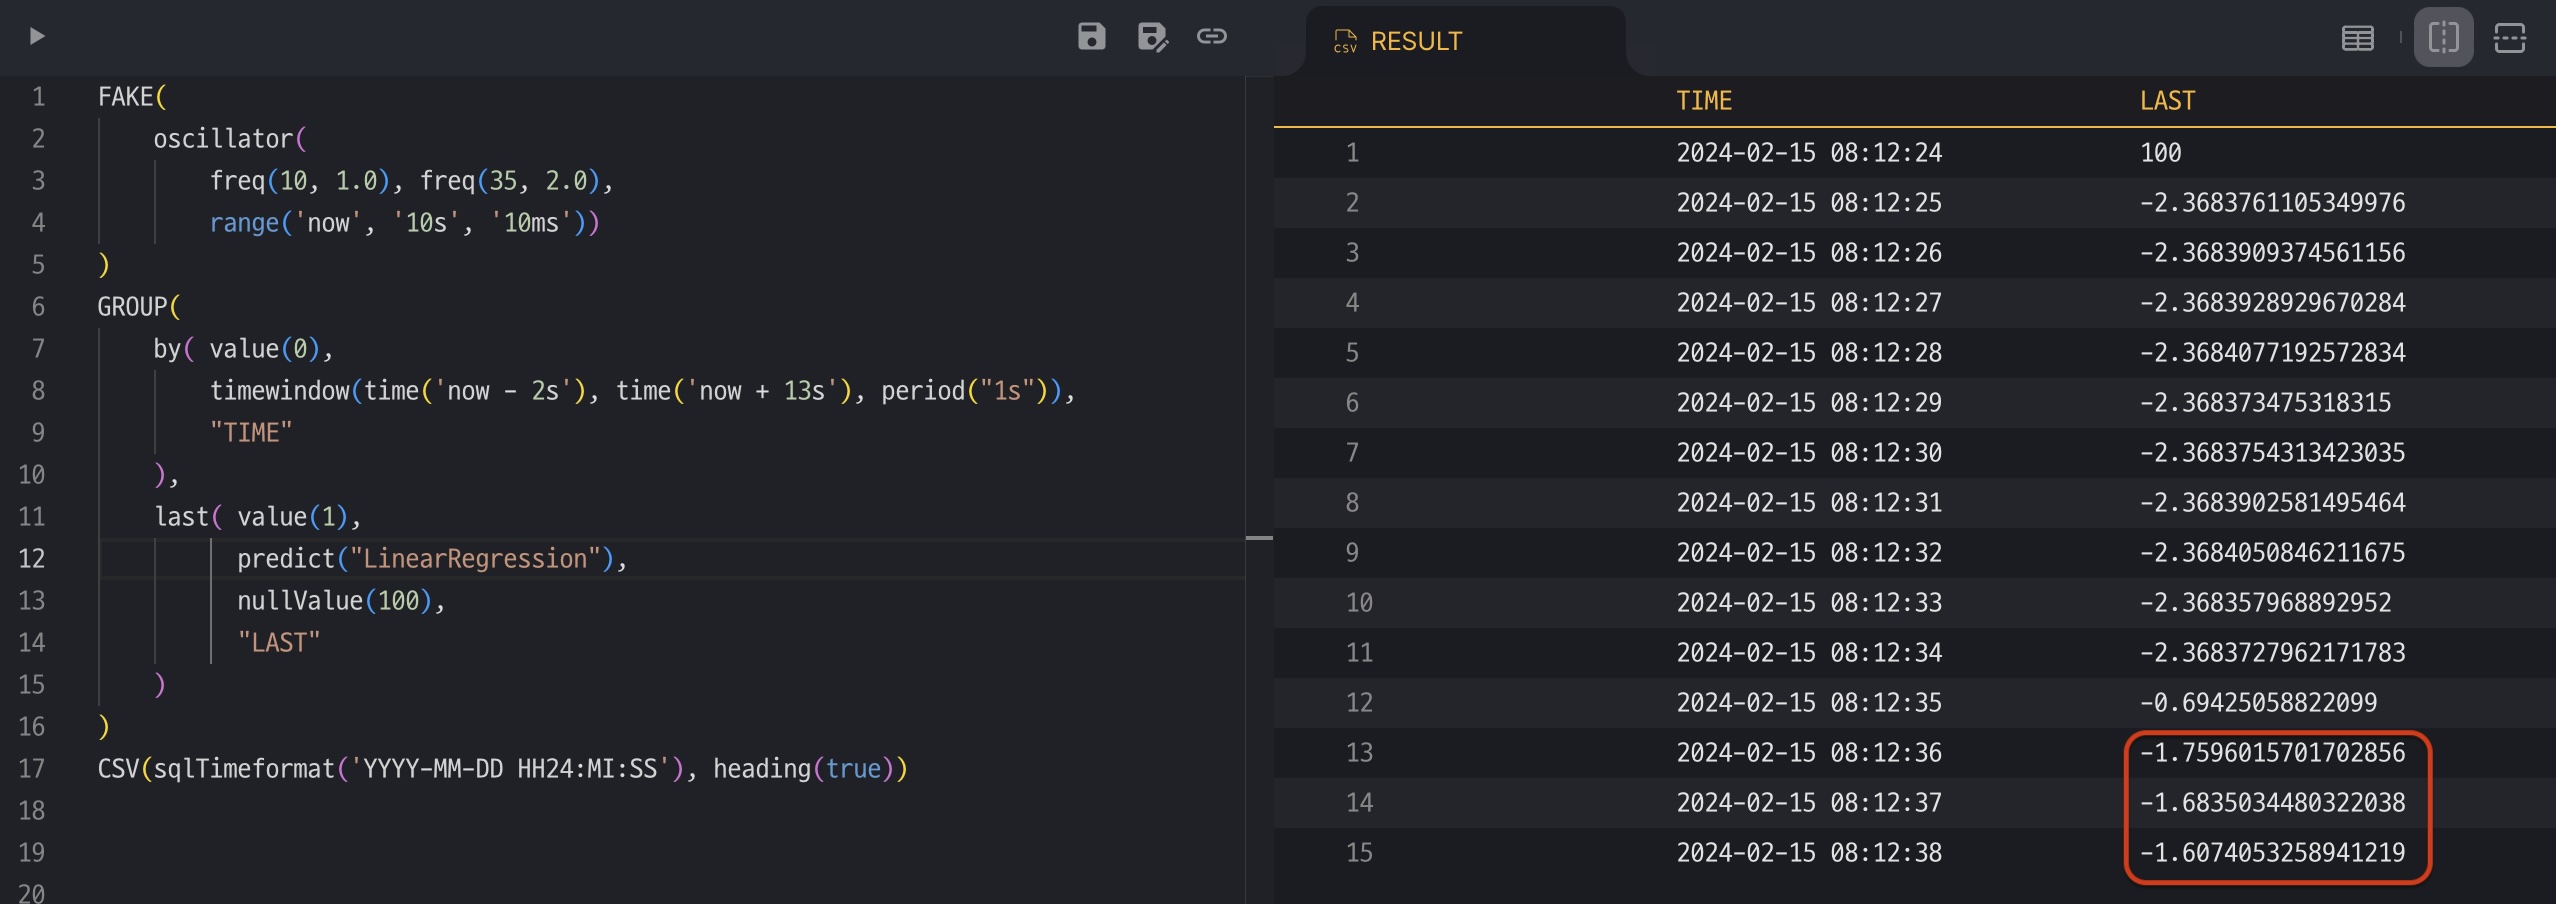
nullValue() で空の値(NULL)を定数で埋めるだけでなく、隣接値を参照して補間したデータを得ることもできます。
上記の例の last() に predict("LinearRegression") を追加して再実行してください。値がなくNULLを返していたレコードに、線形回帰で予測した値が入ります。
予測に必要な隣接値が不足していると、predict() は補間値を生成できない場合があります。その場合は nullValue() を適用し、指定されていなければ NULL を返します。
| |
where()
温度と湿度を測定する2つのセンサーが、それぞれ1秒ごとにデータを保存するとします。 実際のセンサーシステム間には常に時刻差があるため、保存データは次の例のようになることがあります。
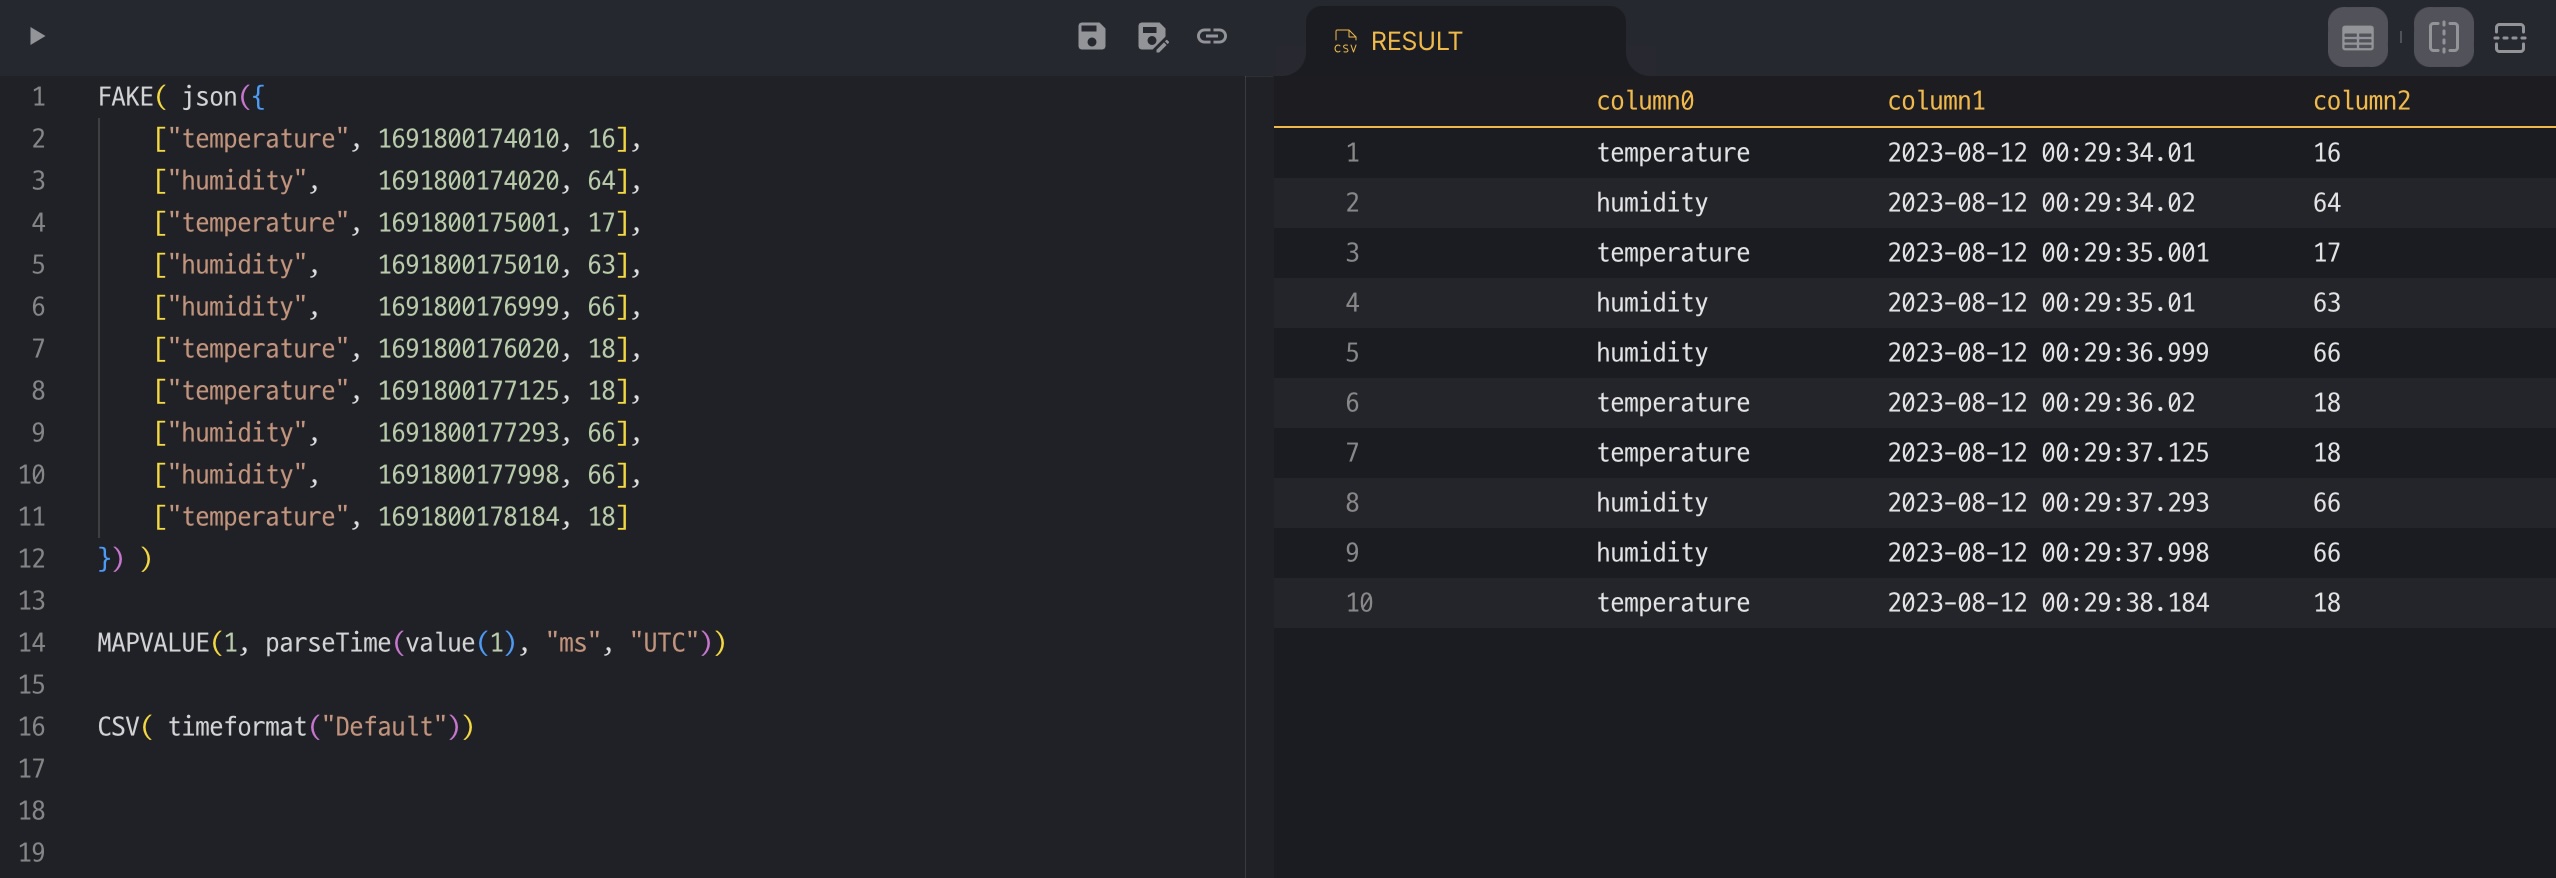
レコード#5の湿度データは想定より早く保存され、レコード#9でも同じことが起きています。 データを秒単位に正規化します。
| |
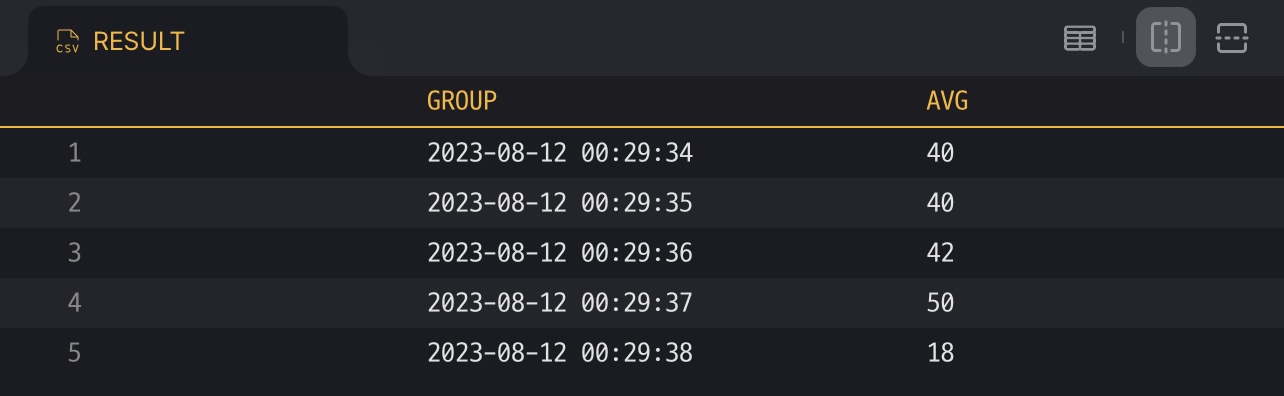
roundTime(..., "1s") で時刻を秒単位に揃え、同じ時刻のレコードをグループ化します。
avg(...) は、グループの平均値を返します。
ただし、温度か湿度かを示す先頭カラムの情報が失われるため、結果の値に意味がなくなります。
これを解決するには where() を使用します。集計関数は、where() の条件が true の場合にのみ値を受け取ります。
| |
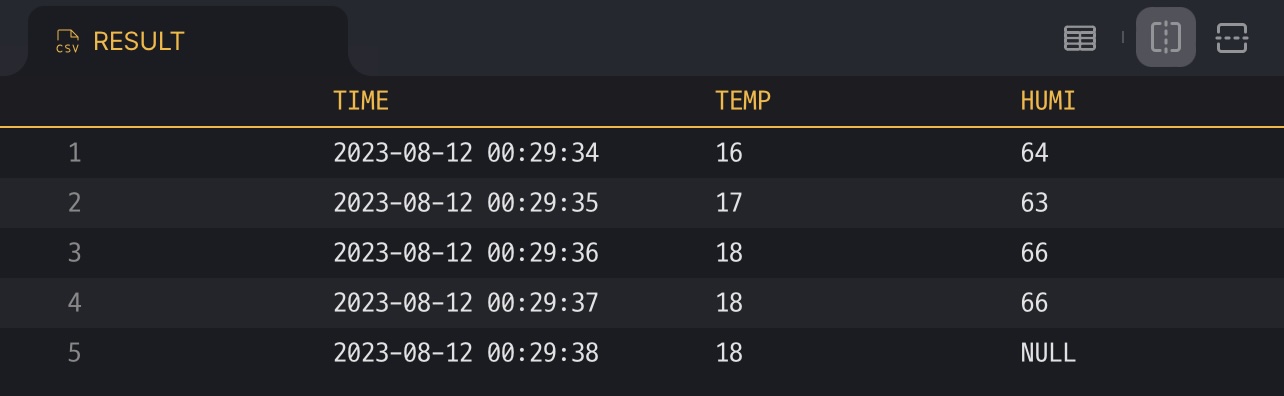
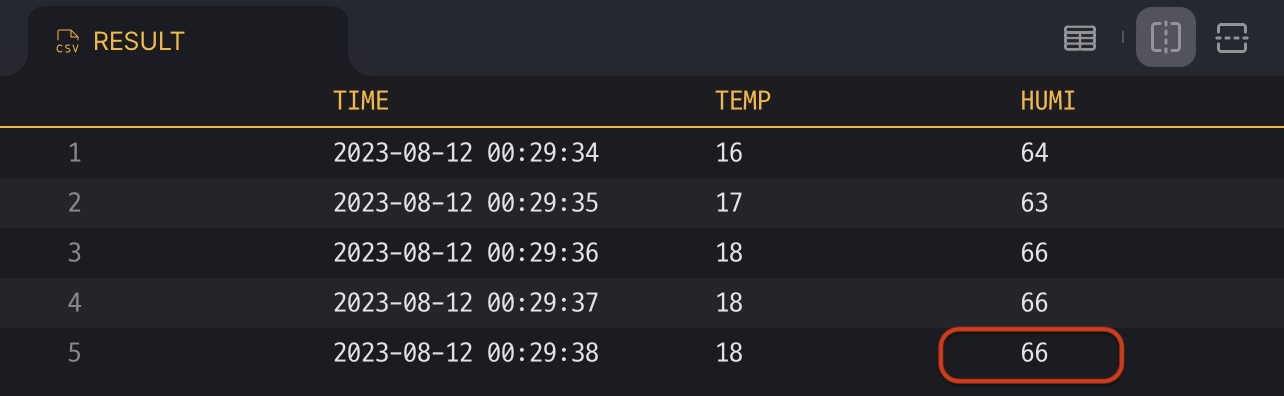
predict() と nullValue() で、最後のレコードの欠損データを補間することもできます。
| |
チャート
| |
結果