DDL
참고: Machbase 8.5 이상에서는 일반 사용자가 이 문서의
CREATE/DROP계열 구문을 실행할 때MACHBASEDB에 대한 데이터베이스 권한이 필요할 수 있습니다. 자세한 권한 부여 방법은 사용자 관리의GRANT/REVOKE를 참고하십시오.
CREATE TABLE
구문
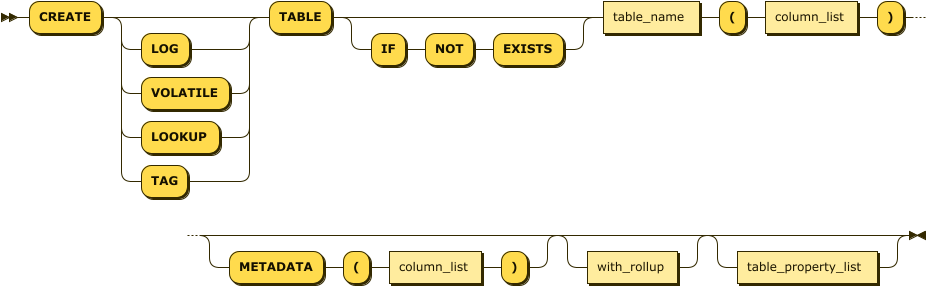
create_table_stmt:
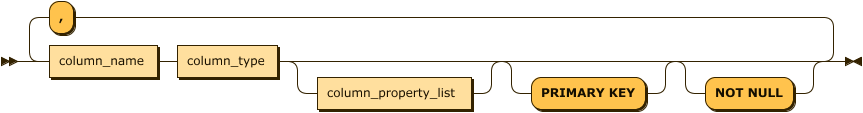
column_list:
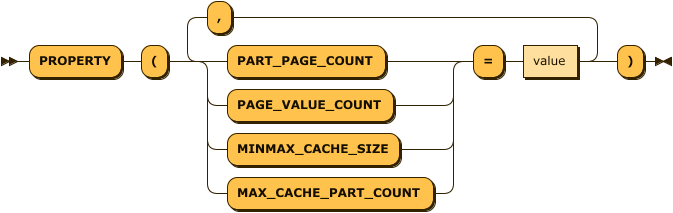
column_property_list:
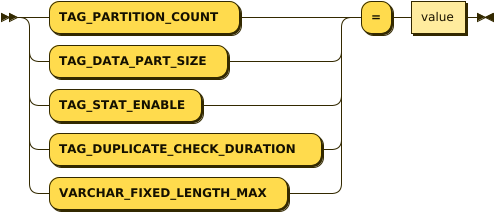
table_property_list:
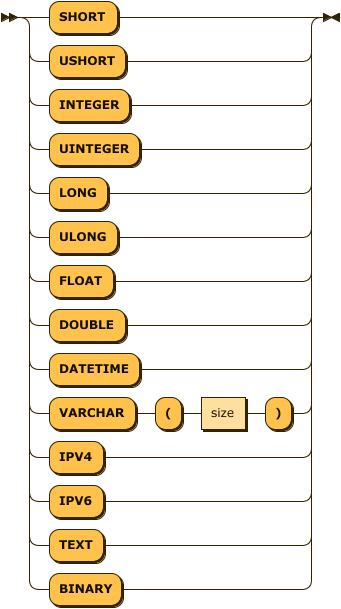
column_type:
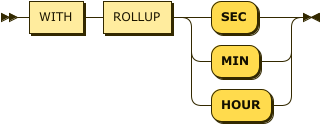
with_rollup:
LOG 테이블 생성
-- create ctest LOG table with 5 columns
CREATE TABLE ctest (id INTEGER, name VARCHAR(20), sipv4 IPV4, dipv6 IPV6, comment TEXT);
TAG 테이블 생성
TAG 테이블에는 PRIMARY KEY 컬럼과 축(axis) 컬럼이 반드시 있어야 합니다. 시간축은 DATETIME BASETIME 또는 DATETIME BASE TIME을 사용하고, 거리축은 DOUBLE, LONG, ULONG 타입에 BASE DISTANCE 또는 BASEDISTANCE를 사용합니다. SUMMARIZED는 선택 속성이며, rollup/통계 정보가 필요한 값 컬럼에 지정합니다.
-- create TAG table
CREATE TAG TABLE tag_time (name VARCHAR(20) PRIMARY KEY, time DATETIME BASETIME, value DOUBLE SUMMARIZED);
CREATE TAG TABLE tag_time_ext (name VARCHAR(20) PRIMARY KEY, time DATETIME BASETIME, value DOUBLE SUMMARIZED, value2 FLOAT, int_column INT);
CREATE TAG TABLE tag_distance (name VARCHAR(20) PRIMARY KEY, distance_m DOUBLE BASE DISTANCE, value DOUBLE, quality INT);
CREATE TAG TABLE tag_distance_meta (name VARCHAR(20) PRIMARY KEY, distance_m LONG BASEDISTANCE, value DOUBLE) METADATA (route_id VARCHAR(20));
거리축 컬럼은 DOUBLE, LONG, ULONG만 허용합니다. WITH ROLLUP은 시간축 Tag 테이블에서만 사용할 수 있습니다.
TAG 메타데이터의 JSON 컬럼과 JSON INDEX(...) 선언은 Tag 메타데이터 문서를 참고하십시오.
테이블 및 컬럼 이름 규칙
테이블 이름과 컬럼 이름은 영숫자(alphanumeric characters)로 이루어집니다. 특수문자를 사용하려면 이름을 큰따옴표(")로 감쌉니다.
CREATE TABLE special_tbl ( "with.dot" INTEGER );IF NOT EXISTS
테이블이 이미 있어도 오류가 발생하지 않도록 합니다. 그러나 기존 테이블의 구조가 CREATE TABLE 문에 지정한 구조와 같은지는 확인하지 않습니다.
기존 테이블과 테이블 종류가 같을 때만 동작합니다.
테이블 종류
| 테이블 종류 | 설명 |
|---|---|
| LOG | CREATE와 TABLE 사이에 아무 키워드도 넣지 않으면 로그 테이블이 생성됩니다. |
| VOLATILE | VOLATILE_TABLE은 모든 데이터가 임시 메모리에 상주하는 임시 테이블입니다. 로그 테이블과 조인하여 결과를 향상시킬 수 있지만, Machbase 서버가 종료되면 데이터가 바로 사라집니다. |
| LOOKUP | VOLATILE_TABLE과 마찬가지로 LOOKUP_TABLE은 모든 데이터를 메모리에 저장하므로 쿼리를 빠르게 처리할 수 있습니다. |
테이블 프로퍼티(Table Property)
테이블의 속성을 지정합니다.
| 프로퍼티 이름 | 사용 가능한 테이블 종류 |
|---|---|
| TAG_PARTITION_COUNT | TAG TABLE |
| TAG_DATA_PART_SIZE | TAG TABLE |
| TAG_STAT_ENABLE | TAG TABLE |
| TAG_DUPLICATE_CHECK_DURATION | TAG TABLE |
| VARCHAR_FIXED_LENGTH_MAX | TAG TABLE |
TAG_PARTITION_COUNT(Default:4)
TAG 테이블에서 지원하는 속성으로, TAG 테이블을 내부적으로 몇 개의 파티션 테이블에 나누어 저장할지 결정합니다. TAG 수나 서버 성능에 맞게 설정해야 합니다.
TAG_DATA_PART_SIZE(Default:16MB)
TAG 테이블에서 지원하는 속성으로, 파티션 테이블별 데이터 크기를 결정합니다.
TAG_STAT_ENABLE(Default:1)
TAG 테이블에서 지원하는 속성으로, TAG ID별 통계 정보의 저장 여부를 결정합니다.
TAG_DUPLICATE_CHECK_DURATION(Default:0, Max:43200)
TAG 테이블에서 지원하는 속성으로, 현재 시스템 시간을 기준으로 중복 제거가 가능한 기간을 분 단위로 설정합니다. 현재 시스템 시간으로부터 설정한 기간 이내의 데이터에 한해서만 중복을 제거하며, 0이면 중복 제거를 수행하지 않습니다.
VARCHAR_FIXED_LENGTH_MAX (Default: 15, Max: 127)
내부 파일의 고정 영역에 저장할 VARCHAR 데이터의 최대 길이를 지정합니다.
컬럼 프로퍼티(Column Property)
컬럼의 속성을 지정합니다.
| 프로퍼티 이름 | 사용 가능한 테이블 종류 |
|---|---|
| PART_PAGE_COUNT | LOG TABLE |
| PAGE_VALUE_COUNT | LOG TABLE |
| MAX_CACHE_PART_COUNT | LOG TABLE |
| MINMAX_CACHE_SIZE | LOG TABLE |
PART_PAGE_COUNT
이 프로퍼티는 하나의 파티션이 가지는 Page의 개수입니다. 하나의 파티션이 가지는 Value의 개수는 PART_PAGE_COUNT * PAGE_VALUE_COUNT가 됩니다.
PAGE_VALUE_COUNT
이 프로퍼티는 하나의 Page가 가지는 Value의 개수입니다.
MAX_CACHE_PART_COUNT (Default : 0)
이 프로퍼티는 성능 향상을 위한 캐시 영역을 설정합니다.
Machbase는 파티션에 접근할 때 해당 파티션의 메타 정보를 담은 메모리 구조체를 먼저 찾습니다. 이 프로퍼티는 몇 개의 파티션 정보를 메모리에 유지할지 결정합니다. 값이 클수록 성능에 도움이 되지만 메모리 사용량이 늘어납니다. 최솟값은 1, 최댓값은 65535입니다.
MINMAX_CACHE_SIZE (Default : 10240)
이 프로퍼티는 해당 컬럼의 MINMAX에 사용할 캐시 메모리 크기를 지정합니다. 0번째 Hidden Column인 _ARRIVAL_TIME은 기본값이 100MB이고, 다른 컬럼은 기본값이 10KB입니다. 이 크기는 테이블을 생성한 뒤에도 “ALTER TABLE MODIFY” 구문으로 변경할 수 있습니다.
NOT NULL 제약 조건
컬럼 값에 NULL을 허용하지 않을 경우 NOT NULL을 지정하고, 허용할 경우(Default)에는 생략합니다.
테이블을 생성한 뒤에 이 제약 조건을 삭제하거나 추가하려면 ALTER TABLE MODIFY COLUMN 명령을 사용합니다.
-- Column c1 is not null and c2 is created without not null constraint.
CREATE TABLE t1(c1 INTEGER NOT NULL, c2 VARCHAR(200));
사전 정의된 시스템 컬럼
CREATE TABLE 문으로 테이블을 생성하면 시스템은 _ARRIVAL_TIME과 _RID라는 두 개의 사전 정의된 시스템 컬럼을 추가로 생성합니다.
_ARRIVAL_TIME 컬럼은 DATETIME 타입의 컬럼으로, INSERT 문이나 AppendData로 데이터를 입력하는 시점의 시스템 시간이 저장되며, 해당 값은 생성된 레코드의 unique key로 사용될 수 있습니다. 이 컬럼의 값은 순서가 보장되는 경우(과거-현재 순으로) machloader나 INSERT 문에서 값을 지정하여 삽입할 수 있습니다. DURATION 조건절을 이용하여 데이터를 검색할 경우, 이 컬럼의 값을 기준으로 데이터를 검색합니다.
_RID 컬럼은 레코드마다 시스템이 생성하는 유일한 값입니다. 이 컬럼의 데이터 타입은 64bit 정수이며, 사용자가 값을 지정하거나 인덱스를 생성할 수 없습니다. 값은 데이터를 INSERT할 때 자동으로 생성됩니다. _RID 컬럼의 값으로 레코드를 검색할 수 있습니다.
create volatile table t1111 (i1 integer);
Created successfully.
Mach> desc t1111;

----------------------------------------------------------------
NAME                          TYPE                LENGTH
----------------------------------------------------------------
_ARRIVAL_TIME                 datetime            8
I1                            integer             4

Mach>insert into t1111 values (1);
1 row(s) inserted.
Mach>select _rid from t1111;
_rid
-----------------------
0
[1] row(s) inserted.

Mach>select i1 from t1111 where _rid = 0;
i1
--------------
1
[1] row(s) selected.
Min Max Cache
Min-Max Cache 개념
일반적인 Disk DBMS에서는 인덱스로 특정 값을 검색할 때 해당 인덱스가 포함된 디스크 영역에 접근한 뒤, 그 값이 들어 있는 최종 디스크 페이지를 찾아갑니다.
반면, Machbase는 시계열 정보를 유지하기 위해 데이터를 시간순으로 파티션한 구조이므로, 하나의 인덱스 정보도 시간순으로 여러 파일에 나뉘어 있습니다. 따라서 Machbase의 인덱스를 사용할 때는 이렇게 파티션별로 나뉜 인덱스 파일을 순차적으로 검색합니다.
검색할 데이터가 1000개의 파티션에 나뉘어 있다면 매번 1000개의 파일을 열어서 검색해야 합니다. 효율적인 컬럼형 데이터베이스 구조로 설계되어 있더라도 이러한 I/O 비용은 인덱스 파티션 개수에 비례하므로, 이를 줄여 성능을 높이는 방법이 MINMAX_CACHE 구조입니다.
MINMAX_CACHE는 각 파티션의 인덱스 파일 정보, 즉 해당 컬럼의 최솟값과 최댓값을 메모리에 유지하는 연속된 메모리 공간입니다. 특정 값이 포함된 파티션을 검색할 때 그 값이 파티션의 최솟값보다 작거나 최댓값보다 크면 해당 파티션을 아예 건너뛸 수 있으므로 고성능 데이터 분석이 가능합니다.
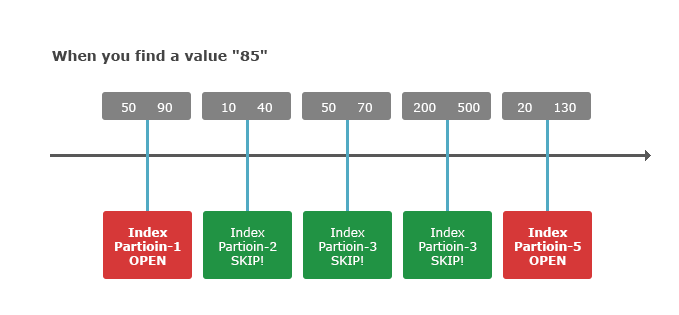
위 그림과 같이 85라는 값을 찾을 때 5개의 파티션 중 MIN/MAX 범위에 값이 포함되는 1번과 5번 파티션만 실제로 검색하고, 2, 3, 4번 파티션은 아예 건너뜁니다.
Min-Max Cache 컬럼
테이블 생성 시에 특정 컬럼에 대해 MINMAX Cache를 사용할 것인지 결정할 수 있습니다.
컬럼의 MINMAX_CACHE_SIZE가 0이 아닌 값으로 설정되어 있으면 해당 컬럼에 대한 인덱스 검색 시 MINMAX Cache가 동작하며, MINMAX_CACHE_SIZE = 0이면 동작하지 않습니다.
MINMAX Cache를 사용할 때는 다음 사항에 주의합니다.
- MINMAX Cache 는 해당 컬럼에 인덱스를 명시적으로 생성하지 않아도 적용됩니다.
- 모든 컬럼의 MINMAX_CACHE_SIZE 기본값은 10KB이며, ALTER TABLE 구문으로 적절한 메모리 크기로 재설정할 수 있습니다.
- 숨겨진 컬럼인 _arrival_time은 기본값이 100MB이며, 자동으로 MINMAX Cache 메모리를 사용합니다.
- VARCHAR 타입은 MINMAX Cache의 대상이 아닙니다. 따라서 VARCHAR 타입 컬럼에 캐시 사용을 명시적으로 지정하면 에러가 발생합니다.
- 테이블을 하나 생성할 때마다 프로퍼티에 설정한 MINMAX_CACHE_SIZE만큼 메모리를 최대로 더 사용할 수 있습니다. 메모리는 파티션 개수가 늘어남에 따라 점진적으로 늘어나 이 최대 크기까지 증가합니다.
- 테이블에 레코드가 하나도 없으면 MINMAX Cache 메모리는 전혀 할당되지 않습니다.
다음은 MINMAX Cache를 설정하여 테이블을 생성하는 예입니다.
-- MINMAX_CACHE_SIZE = 0 for VARCHAR is allowed semantically.
CREATE TABLE ctest (id INTEGER, name VARCHAR(100) PROPERTY(MINMAX_CACHE_SIZE = 0));
Created successfully.
Mach>

-- Cache applied to id column.
CREATE TABLE ctest2 (id INTEGER PROPERTY(MINMAX_CACHE_SIZE = 10240), name VARCHAR(100) PROPERTY(MINMAX_CACHE_SIZE = 0));
Created successfully.
Mach>

-- Applied to id1, id2, and id3.
CREATE TABLE ctest3 (id1 INTEGER PROPERTY(MINMAX_CACHE_SIZE = 10240), name VARCHAR(100) PROPERTY(MINMAX_CACHE_SIZE = 0), id2 LONG PROPERTY(MINMAX_CACHE_SIZE = 1024), id3 IPV4 PROPERTY(MINMAX_CACHE_SIZE = 1024), id4 SHORT);
Created successfully.
Mach>

-- MINMAX_CACHE_SIZE is specified in column units or set to 0.
CREATE TABLE ctest4 (id1 INTEGER PROPERTY(MINMAX_CACHE_SIZE=10240), name VARCHAR(100) PROPERTY(MINMAX_CACHE_SIZE=0), id2 LONG PROPERTY(MINMAX_CACHE_SIZE=10240), id3 IPV4 PROPERTY(MINMAX_CACHE_SIZE=0), id4 SHORT);
Created successfully.
Mach>
기본 키(Primary Key)
Volatile/Lookup 테이블의 컬럼에 부여할 수 있는 제약 조건으로, 해당 컬럼의 값이
중복되는 것을 방지합니다. Lookup 테이블은 기본 키가 필수입니다. Volatile
테이블은 기본 키를 생략할 수 있지만, INSERT ... ON DUPLICATE KEY UPDATE
구문은 대상 테이블에 기본 키가 있을 때만 사용할 수 있습니다.
기본 키를 부여하면, 기본 키에 대응되는 레드-블랙 트리 인덱스가 생성됩니다.
Sequence Column
Lookup 테이블의 SEQUENCE
Lookup 테이블에서 유일한 레코드를 생성하고 데이터의 입력 순서를 결정하기 위해 Sequence가 추가되었습니다.
Lookup 테이블에서 datetime 컬럼으로 레코드의 순서를 구분하면, datetime 값이 중복될 때 레코드의 순서를 구분하기 어렵고 데이터 중복으로 인해 애플리케이션 오류가 발생할 수 있습니다. Sequence는 이러한 문제를 해결하기 위해 추가되었습니다.
Lookup 테이블 생성 시 Sequence 설정
CREATE TABLE 문으로 Lookup 테이블을 생성할 때 Sequence로 사용할 컬럼에 PROPERTY 절을 추가하면 됩니다.
Sequence 컬럼은 LONG 타입(64bit, unsigned)만 지원합니다.
Sequence의 시작값도 설정할 수 있으며, 1로 설정하면 Sequence가 1부터 시작합니다. (0이나 음수는 지원하지 않습니다.)
CREATE LOOKUP TABLE table_name (v1 LONG PROPERTY(SEQUENCE=1) PRIMARY KEY, v2 VARCHAR(10));Sequence 컬럼의 사용
Lookup 테이블의 Sequence 컬럼은 일반 LONG 컬럼과 똑같이 사용할 수 있으며, 이렇게 사용하면 Sequence 값은 자동으로 증가하지 않습니다.
Sequence 컬럼에는 값을 직접 입력할 수 있고, 중복 값도 입력할 수 있습니다.
Sequence 기능을 사용하려면 새로 추가된 Sequence 전용 함수인 nextval로 Sequence 값을 증가시켜야 합니다.
내부적으로 Sequence 컬럼 값 중 가장 큰 값을 저장하고 있으므로, 이후 nextval 함수로 입력하면 Sequence 컬럼 값 중 가장 큰 값 + 1이 저장됩니다.
Sequence 컬럼 사용 예
-- Insert the following Sequence value using nextval Function in the Sequence column.
INSERT INTO table_name (v1, v2) values (nextval(v1), 'aaaa');

-- Insert a value directly into the Sequence column
INSERT INTO table_name (v1, v2) values (100, 'aaaa');

-- Insert a computed value into the Sequence column.
INSERT INTO table_name (v1, v2) values (100 + 1, 'aaaa');

-- Success Select of Lookup Tables with Sequence Columns
SELECT v1, v2 FROM table_name;

-- Invalid Select for Sequence column (nextval column can only be used in insert query)
SELECT nextval(v1), v2 FROM table_name;
CREATE VIEW / DROP VIEW
VIEW는 SELECT 정의를 이름 있는 논리 객체로 저장해 재사용하는 기능입니다.
테이블과 달리 데이터를 별도로 저장하지 않으며, 조회 시 저장된 정의 SQL이 다시
전개되어 실행됩니다.
CREATE VIEW v_example AS
SELECT id, name
FROM t1;

DROP VIEW v_example;
CREATE OR REPLACE VIEW, DROP VIEW IF EXISTS, SHOW VIEWS, M$SYS_VIEWS,
성능/제한, Tag / BINARY 예제까지 포함한 전체 설명은 VIEW 문서를
참고하십시오.
DROP TABLE
drop_table_stmt:
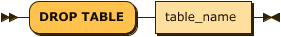
drop_table_stmt ::= 'DROP TABLE' table_name지정된 테이블을 삭제합니다. 단, 해당 테이블을 검색 중인 다른 세션이 있으면 에러와 함께 실패합니다.
-- Example
DROP TABLE TableName;
CREATE TABLESPACE
create_tablespace_stmt:

datadisk_list:
data_disk:
data_disk_property:

create_tablespace_stmt ::= 'CREATE TABLESPACE' tablespace_name 'DATADISK' datadisk_list
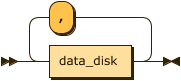
datadisk_list ::= data_disk ( ',' data_disk )*
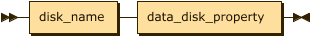
data_disk ::= disk_name data_disk_property
data_disk_property ::= '(' 'DISK_PATH' '=' '"' path '"' ( ',' 'PARALLEL_IO' '=' number )? ')'
-- Example
create tablespace tbs1 datadisk disk1 (disk_path=""); -- $MACHBASE_HOME/dbs/ (Create in $MACHBASE_HOME/dbs/)
create tablespace tbs1 datadisk disk1 (disk_path="tbs1_disk1"); -- $MACHBASE_HOME/dbs/tbs1_disk1 (Created in $MACHBASE_HOME/dbs/tbs1_disk1. tbs1_disk1 folder must exist)
create tablespace tbs2 datadisk disk1 (disk_path="tbs2_disk1", parallel_io = 5);
create tablespace tbs1 datadisk disk1 (disk_path="tbs1_disk1", parallel_io = 10), disk2 (disk_path="tbs1_disk2"), disk3 (disk_path="tbs1_disk3");CREATE TABLESPACE 구문은 로그 테이블 또는 로그 테이블의 인덱스가 저장될 Tablespace를 $MACHBASE_HOME/dbs/에 생성합니다.
Tablespace는 여러 개의 Disk를 가질 수 있습니다. 테이블과 인덱스의 데이터를 저장하는 각 Partition File은 Tablespace에 속한 Data Disk들에 분산되어 저장됩니다.
2개 이상의 Disk를 사용하면 인덱스와 테이블의 파일이 각 Disk에 분산 저장되고, 각 Device에서 I/O가 병렬로 수행됩니다. Disk 개수가 늘어날수록 Disk I/O Throughput이 높아져 대량의 데이터를 빠르게 Disk에 저장할 수 있습니다.
또한 테이블과 인덱스의 Tablespace를 따로 생성하고 각각 다른 Disk를 정의하면, 물리 Disk를 재구성하지 않고도 테이블과 인덱스의 I/O를 논리적으로 분리할 수 있습니다.
DATA DISK
Tablespace에 속한 Disk를 정의합니다. 각 Disk는 다음과 같은 속성을 가집니다.
| 속성 | 설명 |
|---|---|
| data_disk_property | Disk의 속성을 지정합니다. |
| disk_name | Disk 객체의 이름을 지정합니다. 이후 ALTER TABLESPACE 구문으로 Disk 객체의 속성을 변경할 때 사용합니다. |
| disk_path | Disk의 디렉터리 경로를 지정합니다. 이 디렉터리는 미리 생성되어 있어야 합니다. 상대 경로를 지정하면 $MACHBASE_HOME/dbs를 기준으로 PATH를 찾습니다. 예를 들어 PATH=‘disk1’일 경우 Disk Path를 $MACHBASE_HOME/dbs/disk1으로 인식합니다. |
| parallel_io | Disk의 I/O 요청을 병렬로 몇 개까지 허용할지 결정합니다. (DEF: 3, MIN: 1, MAX: 128) |
DROP TABLESPACE
drop_tablespace_stmt:
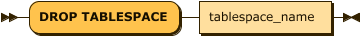
drop_table_stmt ::= 'DROP TABLESPACE' tablespace_name지정된 Tablespace를 삭제합니다. 단, Tablespace에 생성된 객체가 남아 있으면 삭제가 실패합니다.
-- Example
DROP TABLESPACE TablespaceName;
CREATE INDEX
create_index_stmt:
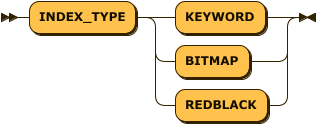
index_type:
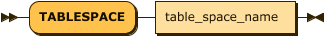
table_space:
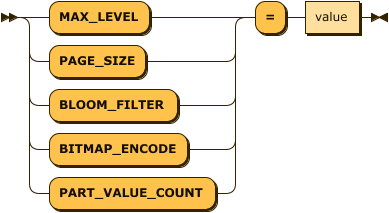
index_property_list:
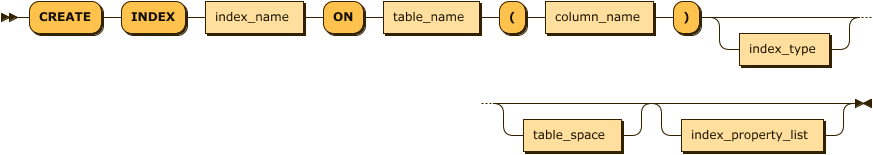
create_index_stmt ::= 'CREATE' 'INDEX' index_name 'ON' table_name '(' column_name ')' index_type? table_space? index_property_list?
index_type ::= 'INDEX_TYPE' ( 'LSM' | 'KEYWORD' | 'BITMAP' | 'REDBLACK' )
table_space ::= 'TABLESPACE' table_space_name
index_property_list ::= ( 'MAX_LEVEL' | 'PAGE_SIZE' | 'BITMAP_ENCODE' | 'PART_VALUE_COUNT' ) '=' value
인덱스 종류
생성할 인덱스 종류를 지정합니다. 키워드 인덱스가 아닌 경우 인덱스 종류를 지정하지 않으면 테이블 종류에 따른 기본 인덱스 종류로 인덱스가 생성됩니다.
| 테이블 종류 | 기본 인덱스 종류 |
|---|---|
| Volatile 테이블 | REDBLACK |
| Lookup 테이블 | REDBLACK |
| Log 테이블 | LSM |
KEYWORD 인덱스
텍스트 검색을 위한 인덱스로, 로그 테이블의 VARCHAR와 TEXT 컬럼에만 생성할 수 있으며 단일 컬럼에 대해서만 생성할 수 있습니다.
LSM 인덱스
LSM(Log Structure Merge) Index는 Big Data의 저장과 검색에 최적화된 인덱스입니다. LSM Index의 Partition은 Level별로 유지되며, 하위 Level의 Partition들이 Merge되어 상위 Level로 이동합니다. 상위 Level의 Partition 생성에 사용된 하위 Partition들은 삭제됩니다.
이러한 Index Level Partition Building은 Background Thread가 수행합니다. 상위 Level Partition은 하위 Level의 Partition 들이 Merge되어 하나의 Partition으로 생성되기 때문에 Index를 통한 검색 시 다음과 같은 장점이 존재합니다.
- Key가 중복된 경우, 한 번만 저장되기 때문에 Key 저장을 위한 Disk Space가 절약됩니다.
- 여러 개의 Partition을 검색하는 대신 하나의 Index Partition을 검색하므로 File Open 및 Close 비용이 줄어들고, 접근하는 Index Page의 개수도 줄어듭니다.
LSM 인덱스 프로퍼티
| 항목 | 설명 |
|---|---|
| MAX_LEVEL (DEFAULT = 3, MIN = 0, MAX = 3 ) | LSM Index의 최대 Level로, 현재 3이 최댓값입니다. 하나의 Partition의 최대 Record 건수는 2억 건을 초과할 수 없습니다. 각 Level의 Partition 크기는 이전 Level Partition의 Value 개수 * 10입니다. 예를 들어 MAX_LEVEL = 3, PART_VALUE_COUNT가 100,000이면 Level 0 = 100,000, Level 1 = 1,000,000, Level 2 = 10,000,000, Level 3 = 100,000,000입니다. 마지막 Level의 Partition Size가 2억 건을 초과하면 Index 생성이 실패합니다. |
| PAGE_SIZE (DEFAULT = 512 * 1024, MIN = 32 * 1024,MAX = 1 * 1024 * 1024) | Index의 Key Value와 Bitmap 값이 저장되는 Page의 크기를 지정합니다. Default는 512K입니다. |
| BITMAP_ENCODE (DEFAULT = EQUAL, RANGE) | 인덱스의 Bitmap 타입을 설정합니다. BITMAP_ENCODE=EQUAL(기본값)이면 키값과 같은 값에 대한 bitmap을 생성하고, BITMAP=RANGE이면 키값의 범위에 따른 bitmap을 생성합니다. 질의 조건으로 =를 주로 사용하면 BITMAP_ENCODE=EQUAL로, 특정 범위를 질의 조건으로 주로 사용하면 BITMAP_ENCODE=RANGE로 설정하는 편이 좋습니다. BITMAP=RANGE이면 EQUAL보다 생성 비용이 약간 증가합니다. |
BITMAP 인덱스
데이터 분석을 위한 인덱스로, 로그 테이블에만 생성할 수 있습니다. VARCHAR, TEXT, BINARY를 제외한 모든 컬럼에 생성할 수 있으며, 단일 컬럼에 대해서만 생성할 수 있습니다.
RED-BLACK 인덱스
실시간 데이터 검색을 위한 메모리 인덱스로, Volatile/Lookup 테이블에만 생성할 수 있습니다. 이 테이블의 모든 컬럼에 생성할 수 있으며, 단일 컬럼에 대해서만 생성할 수 있습니다.
인덱스 프로퍼티
LSM Index에 적용할 수 있는 Property는 다음과 같습니다.
PART_VALUE_COUNT
Index의 Partition에 저장되는 Row 개수입니다.
-- Example
-- Index applied to c1 column.
CREATE INDEX index1 on table1 ( c1 );
-- LSM index applied explicitly.
CREATE INDEX index_lsm on table1 ( c1 ) INDEX_TYPE LSM;
-- Keyword index applied to var_column of varchar type, and page_size unit is 100000.
CREATE INDEX index2 on table1 (var_column) INDEX_TYPE KEYWORD PAGE_SIZE=100000;
JSON path 인덱스
JSON 컬럼의 특정 멤버에 인덱스를 만들 때는 기존 JSONPath arrow 문법과 JSON dot 축약 문법을 모두 사용할 수 있습니다.
CREATE TAG TABLE tag_log (
    name  VARCHAR(40) PRIMARY KEY,
    time  DATETIME BASETIME,
    value JSON
);

-- JSON dot shorthand
CREATE INDEX tag_log_sensor_idx ON tag_log (value.sensor.name);

-- Existing JSONPath arrow syntax
CREATE INDEX tag_log_metric_idx ON tag_log (value->'$.metric');

-- Array index and double quoted key
CREATE INDEX tag_log_item_idx ON tag_log (value.items[0]."product-id");
JSON 컬럼 이름을 큰따옴표로 감싸 생성했거나 keyword를 컬럼 이름으로 사용한 경우에도 기존 arrow DDL 문법을 사용할 수 있습니다.
CREATE TAG TABLE tag_log_q (
    name    VARCHAR(40) PRIMARY KEY,
    time    DATETIME BASETIME,
    "value" JSON
);

CREATE INDEX tag_log_q_idx ON tag_log_q ("value"->'$.sensor.name');

CREATE TAG TABLE tag_log_kw (
    name   VARCHAR(40) PRIMARY KEY,
    time   DATETIME BASETIME,
    "LEFT" JSON
);

CREATE INDEX tag_log_kw_idx ON tag_log_kw (left->'$.sensor.name');
문자열 비교 조건에는 JSON path 인덱스를 사용할 수 있습니다. 숫자나 boolean 의미의 비교 조건은 문자열 정렬과 숫자 정렬이 다를 수 있으므로 JSON path 인덱스의 range 조건으로 사용하지 않습니다.
TAGDATA 메타데이터의 JSON path 인덱스 사용법은 Tag 메타데이터 및 Tag 테이블 인덱스 문서를 참고하십시오.
DROP INDEX
drop_index_stmt:
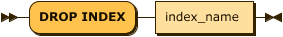
drop_index_stmt ::= 'DROP INDEX' index_name지정된 인덱스를 삭제합니다. 단, 해당 테이블을 검색 중인 다른 세션이 있으면 에러와 함께 실패합니다.
-- Example
DROP INDEX IndexName;
ALTER TABLE
ALTER TABLE 구문은 지정된 테이블의 스키마 정보를 변경할 때 사용합니다.
- 대부분의 ALTER TABLE 작업은 Log 테이블에서만 사용할 수 있습니다.
- RENAME COLUMN 작업은 Log 테이블과 Tag 테이블 모두에서 사용할 수 있습니다.
ALTER TABLE SET
이 구문은 테이블의 Property를 변경합니다. 현재 동적으로 변경 가능한 Property는 없습니다.
ALTER TABLE ADD COLUMN
alter_table_add_stmt:

alter_table_add_stmt ::= 'ALTER TABLE' table_name 'ADD COLUMN' '(' column_name column_type ( 'DEFAULT' value )? ')'이 구문은 테이블에 컬럼을 실시간으로 추가합니다. 컬럼의 이름과 타입을 지정하고, DEFAULT 절로 기본 데이터 값을 설정할 수 있습니다.
-- Example-1
alter table atest2 add column (id4 float);

-- Example-2
alter table atest2 add column (id6 double  default 5);
alter table atest2 add column (id7 ipv4  default '192.168.0.1');
alter table atest2 add column (id8 varchar(4) default 'hello');
ALTER TABLE DROP COLUMN
alter_table_drop_stmt:

alter_table_drop_stmt ::= 'ALTER TABLE' table_name 'DROP COLUMN' '(' column_name ')'이 구문은 테이블의 특정 컬럼을 실시간으로 삭제합니다.
-- Example
alter table atest2 drop column (id4);
alter table atest2 drop column (id8);
ALTER TABLE METADATA ADD COLUMN
alter_table_metadata_add_stmt:
alter_table_metadata_add_stmt ::= 'ALTER TABLE' table_name 'METADATA ADD COLUMN' '(' column_name column_type ( 'DEFAULT' value )? ')'이 구문은 TAG 테이블에 메타데이터 컬럼을 추가합니다. 메타데이터 컬럼에는 데이터 포인트마다 자주 바뀌지 않는 태그별 정보를 저장합니다.
참고: 이 작업은 TAG 테이블에서만 사용할 수 있습니다.
-- Example: Add metadata columns to a TAG table
ALTER TABLE altertbl METADATA ADD COLUMN (m1 DOUBLE);
ALTER TABLE altertbl METADATA ADD COLUMN (m2 VARCHAR(100));
ALTER TABLE altertbl METADATA ADD COLUMN (m3 INTEGER DEFAULT 0);
ALTER TABLE METADATA DROP COLUMN
alter_table_metadata_drop_stmt:
alter_table_metadata_drop_stmt ::= 'ALTER TABLE' table_name 'METADATA DROP COLUMN' '(' column_name ')'이 구문은 TAG 테이블에서 메타데이터 컬럼을 삭제합니다.
참고: 이 작업은 TAG 테이블에서만 사용할 수 있습니다.
-- Example: Drop metadata columns from a TAG table
ALTER TABLE altertbl METADATA DROP COLUMN (m1);
ALTER TABLE altertbl METADATA DROP COLUMN (m2);
ALTER TABLE RENAME COLUMN
alter_table_column_rename_stmt:

alter_table_column_rename_stmt ::= 'ALTER TABLE' table_name 'RENAME COLUMN' old_column_name 'TO' new_column_name이 구문은 테이블의 특정 컬럼 이름을 변경합니다. 이 작업은 Log 테이블과 Tag 테이블 모두에서 사용할 수 있습니다.
-- Example for Log Table
alter table atest2 rename column id7 to id7_rename;

-- Example for Tag Table
alter table tag rename column v0001 to vmax;참고: Tag 테이블에서는 추가 값 컬럼뿐 아니라 PRIMARY KEY, BASETIME, METADATA 컬럼을 포함한 모든 컬럼의 이름을 변경할 수 있습니다. 단, Tag 테이블에 ROLLUP 테이블이 정의되어 있으면 컬럼 이름 변경이 제한될 수 있습니다.
참고: Tag 테이블의 RENAME COLUMN 작업은 Machbase 8.0.50 이상에서 지원됩니다.
ALTER TABLE MODIFY COLUMN
alter_table_modify_stmt:
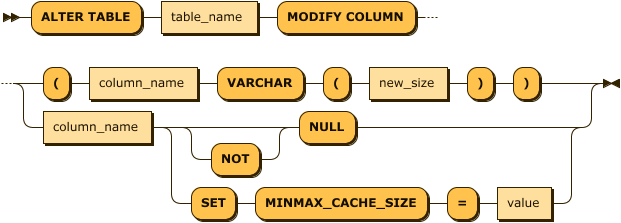
alter_table_modify_stmt ::= 'ALTER TABLE' table_name 'MODIFY COLUMN' ( '(' column_name 'VARCHAR' '(' new_size ')' ')' | column_name ( 'NOT'? 'NULL' | 'SET' 'MINMAX_CACHE_SIZE' '=' value ) )이 구문은 테이블의 특정 컬럼 속성을 변경합니다. 현재는 VARCHAR 타입 컬럼의 길이와, 그 밖의 타입 컬럼의 MINMAX CACHE 속성 및 NOT NULL 제약 조건을 변경할 수 있습니다.
VARCHAR SIZE
이 구문은 VARCHAR 타입 컬럼의 길이 변경만 지원합니다. 기존 데이터를 보존하기 위해 길이를 줄일 수는 없으며, 항상 늘려야 합니다.
ALTER TABLE table_name MODIFY COLUMN (column_name VARCHAR(new_size));-- Example: Assume TABLE is created like this.
-- create table atest5 (id integer, name varchar(5), id3 double, id4 float);
-- Error occurred: Can not change to another type,
alter table atest5 modify column (id varchar(10));
-- Error occurred: VARCHAR length can not be made smaller.
alter table atest5 modify column (name varchar(3));
-- Error occurred: Maximum size of VARCHAR can not exceed 32767.
alter table atest5 modify column (name varchar(32768));
-- Success
alter table atest5 modify column (name varchar(128));MINMAX_CACHE_SIZE
이 구문은 특정 컬럼에 대해 MINMAX_CACHE_SIZE를 변경합니다.
ALTER TABLE table_name MODIFY COLUMN column_name SET MINMAX_CACHE_SIZE=value;-- Example: Assume TABLE is created like this.
create table atest9 (id integer, name varchar(100));
-- Error: Does not apply to VARCHAR.
alter table atest9 modify column name set minmax_cache_size=0;
[ERR-02139 : MINMAX CACHE is not allowed for VARCHAR column(NAME).]
-- Change success
alter table atest9 modify column id set minmax_cache_size=10240;NOT NULL
컬럼에 NOT NULL 제약 조건을 추가합니다. 컬럼에 이미 NULL 값이 있으면 DDL 연산이 실패합니다.
컬럼에 NULL 값을 허용하려면 이어서 설명하는 MODIFY COLUMN NULL 명령을 사용합니다.
ALTER TABLE table_name MODIFY COLUMN column_name NOT NULL;-- Add NOT NULL constraint to t1.c1.
alter table t1 modify column c1 not null;NULL
NOT NULL 제약 조건을 해제하여 NULL 값을 입력할 수 있게 합니다. 이 경우 LSM 인덱스의 min_max 캐시로 인한 성능 향상은 얻을 수 없습니다.
ALTER TABLE table_name MODIFY COLUMN column_name NULL;-- Release NOT NULL constraint at t1.c1.
alter table t1 modify column c1 null;ALTER TABLE RENAME TO
alter_table_rename_stmt:

alter_table_rename_stmt ::= 'ALTER TABLE' table_name 'RENAME TO' new_name테이블의 이름을 변경합니다.
메타 테이블은 이름을 변경할 수 없고, 새 이름에는 $ 문자를 사용할 수 없습니다. 테이블 이름 변경은 Log 테이블에서만 가능합니다.
-- Change the name of worker table to employee.
ALTER TABLE worker RENAME TO employee;
ALTER TABLE ADD RETENTION
alter_table_add_retention_stmt:
alter_table_add_retention_stmt ::= 'ALTER TABLE' table_name 'ADD RETENTION' policy_name
ALTER TABLE tag ADD RETENTION policy_1d_1h;ALTER TABLE DROP RETENTION
alter_table_drop_retention_stmt:
alter_table_drop_retention_stmt ::= 'ALTER TABLE' table_name 'DROP RETENTION'
ALTER TABLE tag DROP RETENTION;ALTER TABLESPACE
ALTER TABLESPACE 구문은 지정된 Tablespace의 정보를 변경할 때 사용합니다.
ALTER TABLESPACE MODIFY DATADISK
이 구문은 Tablespace에 속한 DATADISK의 속성을 변경할 때 사용합니다.
alter_tablespace_stmt:

alter_tablespace_stmt ::= 'ALTER TABLESPACE' table_name 'MODIFY DATADISK' disk_name 'SET' 'PARALLEL_IO' '=' value-- Example
ALTER TABLESPACE tbs1 MODIFY DATADISK disk1 SET PARALLEL_IO = 10;TRUNCATE TABLE
truncate_table_stmt:
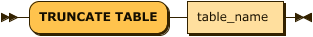
truncate_table_stmt ::= 'TRUNCATE TABLE' table_name-- Delete all data in ctest table.
Mach> truncate table ctest;
Truncated successfully.지정된 테이블의 모든 데이터를 삭제합니다. 단, 해당 테이블을 검색 중인 다른 세션이 있으면 에러와 함께 실패합니다.
CREATE ROLLUP
create_rollup_stmt:
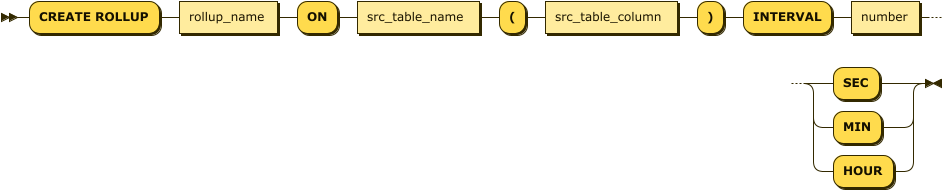
create_rollup_stmt ::= 'CREATE ROLLUP' rollup_name 'ON' src_table_name '('src_table_column')' 'INTERVAL' number ('SEC' | 'MIN' | 'HOUR')-- Creates a rollup targeting the value column of the tag table.
Mach> CREATE ROLLUP _rollup_tag_value_sec ON tag(value) INTERVAL 1 SEC;
Executed successfullyJSON 컬럼의 멤버를 rollup 대상 값으로 사용할 때는 기존 JSONPath arrow 문법과 JSON dot 축약 문법을 모두 사용할 수 있습니다.
CREATE TAG TABLE tag_json (
    name  VARCHAR(40) PRIMARY KEY,
    time  DATETIME BASETIME,
    value JSON
);

-- JSON dot shorthand
CREATE ROLLUP tag_json_metric_ru
ON tag_json (value.metric)
INTERVAL 1 SEC;

-- Existing JSONPath arrow syntax
CREATE ROLLUP tag_json_metric_arrow_ru
ON tag_json (value->'$.metric')
INTERVAL 1 SEC;

-- Array index and double quoted key
CREATE ROLLUP tag_json_item_ru
ON tag_json (value.items[0]."metric-id")
INTERVAL 1 SEC;
따옴표로 감싼 컬럼 이름과 keyword 컬럼 이름도 기존 arrow 문법으로 계속 사용할 수 있습니다.
CREATE TAG TABLE tag_json_q (
    name    VARCHAR(40) PRIMARY KEY,
    time    DATETIME BASETIME,
    "value" JSON
);

CREATE ROLLUP tag_json_q_ru
ON tag_json_q ("value"->'$.metric')
INTERVAL 1 SEC;

CREATE TAG TABLE tag_json_kw (
    name   VARCHAR(40) PRIMARY KEY,
    time   DATETIME BASETIME,
    "LEFT" JSON
);

CREATE ROLLUP tag_json_kw_ru
ON tag_json_kw (left->'$.metric')
INTERVAL 1 SEC;
원본 데이터를 보정하여 기존 rollup 집계 결과를 다시 만들어야 하는 경우에는 Rollup Rebuild 사용자 가이드를 참고하십시오.
create_conditional_rollup_stmt ::= 'CREATE ROLLUP' rollup_name
                                   ( 'ON' src_table_name '('src_table_column')'
                                   | 'FROM' src_rollup_table_name )
                                   'INTERVAL' number ('SEC' | 'MIN' | 'HOUR')
                                   'WHERE' predicate
-- Conditional rollup: aggregates only rows where value2 = 0
Mach> CREATE ROLLUP _rollup_tag_value_min_ok
ON tag(value)
INTERVAL 1 MIN
WHERE value2 = 0;
Executed successfullycreate_custom_rollup_stmt ::= 'CREATE ROLLUP' rollup_name
'INTO' '(' dest_table_name ')'
'AS' '(' select_stmt ')'
'INTERVAL' number ('SEC' | 'MIN' | 'HOUR')
[ 'WAKEUP INTERVAL' number ('SEC' | 'MIN' | 'HOUR') ]-- Creates a custom rollup that stores user-defined aggregation into a TAG table.
Mach> CREATE ROLLUP rollup_stock_1m
INTO (stock_rollup_1m)
AS (
SELECT code,
DATE_TRUNC('minute', time) AS time,
SUM(price) AS sum_price,
COUNT(*) AS cnt
FROM stock_tick
GROUP BY code, time
)
INTERVAL 1 MIN;
Executed successfully주의 사항
- 조건부 rollup의
WHERE는ON/FROMrollup 문법에서 사용합니다. - Custom Rollup에서는
SELECT내부에서만WHERE를 사용합니다. INTERVAL ... WHERE ...형태의 외부 WHERE는 Custom Rollup 문법에서 지원하지 않습니다.- 자세한 제약 사항과 쿼리 패턴은 Custom Rollup: 사용자 정의 집계를 참고합니다.
DROP ROLLUP
drop_rollup_stmt:
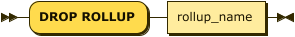
drop_rollup_stmt ::= 'DROP ROLLUP' rollup_name-- drop rollup.
Mach> DROP ROLLUP _rollup_tag_value_sec;
Executed successfullyALTER ROLLUP
롤업 워커와 wakeup 주기를 제어합니다.
alter_rollup_start_stop_stmt ::= 'ALTER ROLLUP' rollup_name ( 'START' | 'STOP' )
alter_rollup_force_stmt      ::= 'ALTER ROLLUP' rollup_name 'FORCE'
alter_rollup_wakeup_stmt     ::= 'ALTER ROLLUP' rollup_name 'WAKEUP'
alter_rollup_wakeup_int_stmt ::= 'ALTER ROLLUP' rollup_name 'SET WAKEUP INTERVAL' number ( 'SEC' | 'MIN' | 'HOUR' )
예제
-- Start/stop a rollup thread
ALTER ROLLUP _rollup_tag_value_sec START;
ALTER ROLLUP _rollup_tag_value_sec STOP;

-- Wake the thread now (non-blocking)
ALTER ROLLUP _rollup_tag_value_sec WAKEUP;

-- Run immediately and wait for completion
ALTER ROLLUP _rollup_tag_value_sec FORCE;

-- Tighten the wakeup interval (must divide the rollup interval)
ALTER ROLLUP _rollup_tag_value_sec SET WAKEUP INTERVAL 1 SEC;
규칙
- wakeup 주기는 0보다 커야 하고 롤업 주기보다 클 수 없으며, 롤업 주기를 나누어떨어지게 하는 값(약수)이어야 합니다. 조건을 위반하면 에러를 반환합니다.
WAKEUP은 스레드를 깨우기만 하고 바로 반환합니다. 집계가 따라잡을 때까지 대기해야 하면FORCE를 사용합니다.
CREATE RETENTION
create_retention_stmt:
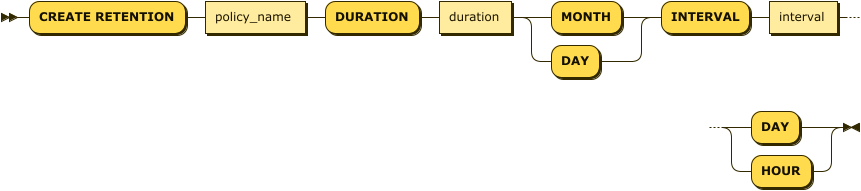
create_retention_stmt ::= 'CREATE RETENTION' policy_name 'DURATION' duration ( 'MONTH' | 'DAY' ) 'INTERVAL' interval ( 'DAY' | 'HOUR' )-- Creates a retention policy.
Mach> CREATE RETENTION policy_1d_1h DURATION 1 DAY INTERVAL 1 HOUR;
Executed successfullyDROP RETENTION
drop_retention_stmt:
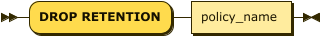
drop_retention_stmt ::= 'DROP RETENTION' policy_name-- Drops the retention policy.
Mach> DROP RETENTION policy_1d_1h;
Executed successfully