집계용 롤업 테이블
개요
롤업 테이블은 태그 데이터를 시간 기준으로 자동 집계해 분석과 리포트 쿼리의 성능을 크게 높입니다. 수백만 건의 원시 데이터를 스캔하는 대신, 여러 시간 간격별 통계를 미리 계산해 둡니다.
TIME 축 전용 기능
ROLLUP은 시간축(BASETIME, BASE TIME) Tag 테이블에서만 사용할 수 있습니다. 거리축(BASE DISTANCE, BASEDISTANCE) Tag 테이블에서는 아래 기능을 지원하지 않습니다.
WITH ROLLUP(...)CREATE ROLLUP ... ON <distance_tag> ...CREATE ROLLUP ... INTO (...) AS (...)
예를 들어 아래 구문은 실패합니다.
CREATE TAG TABLE trip_rollup_test (
    name        VARCHAR(20) PRIMARY KEY,
    distance_m  DOUBLE BASE DISTANCE,
    value       DOUBLE SUMMARIZED
) WITH ROLLUP(SEC);

[ERR-04999: ROLLUP is not supported on DISTANCE axis TAG table.]
거리축 테이블에서는 대신 다음 방식을 사용합니다.
BETWEEN a AND b조건으로 직접 범위 조회TRUNC(distance / bucket, 0) * bucket형태의 버킷 집계EXPLAIN으로 거리 조건이 key range로 들어가는지 확인
ROLLUP 테이블 생성
Tag 테이블을 생성해도 Rollup은 기본으로 생성되지 않습니다. 아래 문법으로 직접 생성합니다.
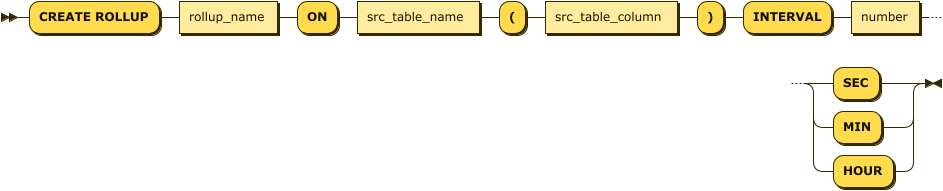
공개 문법은 다음과 같습니다.
CREATE ROLLUP [IF NOT EXISTS] rollup_name
  ON source_table(column_name)
  INTERVAL n (SEC|MIN|HOUR)
  [WAKEUP INTERVAL m (SEC|MIN|HOUR)]
  [EXTENSION]
  [WHERE predicate];

CREATE ROLLUP [IF NOT EXISTS] rollup_name
  ON source_table(json_column->'$.path')
  INTERVAL n (SEC|MIN|HOUR)
  [WAKEUP INTERVAL m (SEC|MIN|HOUR)]
  [WHERE predicate];

CREATE ROLLUP [IF NOT EXISTS] rollup_name
  FROM source_rollup_table
  INTERVAL n (SEC|MIN|HOUR)
  [WAKEUP INTERVAL m (SEC|MIN|HOUR)]
  [EXTENSION]
[WHERE predicate];- rollup name : 생성할 rollup table의 이름 (40자 이내의 문자열로 자유롭게 지정 가능)
- source table name : 생성할 rollup이 데이터를 집계할 source table 이름
- src_table_column : rollup 대상 데이터 칼럼 이름
- 기본적으로 숫자형 타입의 칼럼만 지정할 수 있습니다.
JSON SUMMARIZED타입 칼럼은value의 JSON 문서 전체를 집계하는 특수 모드로 지원합니다.- source table이 rollup table이면 생략하며, source table의 rollup 대상 칼럼이 자동으로 지정됩니다.
- number sec/min/hour : 집계할 시간 숫자와 시간 단위
ex) 1초 단위 집계 : 1 sec
ex) 30초 단위 집계 : 30 sec
ex) 1분 단위 집계 : 1 min
ex) 1시간 단위 집계 : 1 hour - 제약조건
- 집계할 source table로는 tag table 또는 rollup table만 지정할 수 있습니다.
- 집계할 source table이 rollup table이면, 생성할 rollup table의 시간 간격은 source table의 시간 간격보다 커야 하며 그 배수여야 합니다.
롤업 테이블 생성 예시
Mach> CREATE TAG TABLE tag (name VARCHAR(20) PRIMARY KEY, time DATETIME BASETIME, value DOUBLE, strvalue VARCHAR(20));
Executed successfully.

-- tag table의 value 칼럼 대상 1초 rollup 생성
Mach> CREATE ROLLUP _tag_rollup_sec ON tag(value) INTERVAL 1 SEC;

-- tag table의 value 칼럼 대상 1분 rollup 생성
Mach> CREATE ROLLUP _tag_rollup_min ON tag(value) INTERVAL 1 MIN;

-- tag table 대상 1시간 rollup 생성
Mach> CREATE ROLLUP _tag_rollup_hour ON tag(value) INTERVAL 1 HOUR;

-- tag table 대상 30초 rollup 생성
Mach> CREATE ROLLUP _tag_rollup_30sec ON tag(value) INTERVAL 30 SEC;

-- rollup table(위 30초 rollup) 대상 10분 rollup 생성
Mach> CREATE ROLLUP _tag_rollup_10min ON _tag_rollup_30sec INTERVAL 10 MIN;

-- 숫자형 타입이 아닌 칼럼에 대해 rollup 생성 시 에러
Mach> CREATE ROLLUP _tag_rollup_sec ON tag(strvalue) INTERVAL 1 SEC;
[ERR-02671: Invalid type for ROLLUP column (STRVALUE).]
ROLLUP 테이블 자동 생성
WITH ROLLUP (time_unit) 키워드를 사용해 롤업 테이블을 자동으로 생성할 수 있습니다.
CREATE TAG TABLE tagtbl (name VARCHAR(20) PRIMARY KEY, time DATETIME BASETIME, value DOUBLE SUMMARIZED) WITH ROLLUP (time_unit)

time_unit := {SEC|MIN|HOUR}
아래와 같이 time_unit을 생략하면 SEC를 기준으로 생성합니다.
CREATE TAG TABLE tagtbl (name VARCHAR(20) PRIMARY KEY, time DATETIME BASETIME, value DOUBLE SUMMARIZED) WITH ROLLUP자동으로 생성되는 rollup의 이름은 다음 형식을 따릅니다. (tagtbl 자리에 tag table 이름이 들어갑니다.)
- _
tagtbl_ROLLUP_SEC - _
tagtbl_ROLLUP_MIN - _
tagtbl_ROLLUP_HOUR
Mach> CREATE TAG TABLE tagtbl (name VARCHAR(20) PRIMARY KEY, time DATETIME BASETIME, value DOUBLE SUMMARIZED) WITH ROLLUP (SEC)

Mach> SHOW TABLES;
USER_NAME             DB_NAME                                             TABLE_NAME                                          TABLE_TYPE
-----------------------------------------------------------------------------------------------------------------------------------------------
SYS                   MACHBASEDB                                          TAGTBL                                              TAGDATA
SYS                   MACHBASEDB                                          _TAGTBL_DATA_0                                      KEYVALUE
SYS                   MACHBASEDB                                          _TAGTBL_DATA_1                                      KEYVALUE
SYS                   MACHBASEDB                                          _TAGTBL_DATA_2                                      KEYVALUE
SYS                   MACHBASEDB                                          _TAGTBL_DATA_3                                      KEYVALUE
SYS                   MACHBASEDB                                          _TAGTBL_META                                        LOOKUP
SYS                   MACHBASEDB                                          _TAGTBL_ROLLUP_HOUR                                 KEYVALUE
SYS                   MACHBASEDB                                          _TAGTBL_ROLLUP_MIN                                  KEYVALUE
SYS                   MACHBASEDB                                          _TAGTBL_ROLLUP_SEC                                  KEYVALUE
[9] row(s) selected.
Elapsed time: 0.001
Mach>time_unit에 지정한 단위를 가장 작은 단위로 보고, 그보다 큰 시간 단위의 rollup까지 자동으로 생성합니다.
롤업 테이블 이름이 충돌하면 롤업 테이블 생성은 모두 실패하고 태그 테이블만 생성됩니다.
rollup을 자동으로 생성할 때 rollup의 DATA_PART_SIZE를 바이트 단위로 설정할 수 있습니다.
CREATE TAG TABLE tagtbl (name VARCHAR(20) PRIMARY KEY, time DATETIME BASETIME, value DOUBLE SUMMARIZED) WITH ROLLUP ROLLUP_DATA_PART_SIZE=(data_part_size)확장 ROLLUP
Rollup 테이블 생성 구문 마지막에 EXTENSION 키워드를 추가하면 확장 Rollup을 생성할 수 있습니다.
확장 Rollup은 각 구간의 시작 값과 종료 값도 함께 저장합니다.
-- 확장 Rollup 테이블 수동 생성
CREATE ROLLUP _tag_rollup_sec ON tag(value) INTERVAL 1 SEC EXTENSION;

-- 확장 Rollup 테이블 자동 생성
CREATE TAG TABLE tagtbl (name VARCHAR(20) PRIMARY KEY, time DATETIME BASETIME, value DOUBLE SUMMARIZED) WITH ROLLUP EXTENSION;
조건부 롤업·필터·힌트
이 기능이 해결하는 문제
주기·값 컬럼·JSON PATH가 같은 롤업이 여러 개 있을 때, 엔진은 “조건 없는” 롤업과 “조건 있는”(필터) 롤업을 구분해 조건 없는 롤업을 자동으로 우선 선택합니다. 필요하면 힌트로 특정 롤업을 강제로 사용할 수 있습니다. 필터 조건은 생성 시점에 검증되므로 혼란스럽거나 안전하지 않은 정의는 즉시 거부됩니다.
조건 있는 롤업 생성 방법
CREATE ROLLUP <rollup_name>
  ( ON <table_name>(<value_col>)
  | FROM <src_rollup_table_name> )
  INTERVAL <n> <SEC|MIN|HOUR>
WHERE <predicate>;WHERE조건은 집계 전에 원본 행에 적용되며, 조건에 사용한 컬럼은 롤업 테이블에 저장되지 않습니다.- 허용: 존재하는 컬럼을 참조하는 일반 스칼라 표현식(AND/OR/NOT, 비교, BETWEEN, IN, LIKE, CASE, 비집계 함수).
value2,status같은 비요약 컬럼도 조건에 사용할 수 있습니다. - 금지: 서브쿼리, 집계 함수, 존재하지 않는 컬럼, 태그 테이블의 태그명(PK) 컬럼 조건(내부적으로 숫자 ID이므로 문자열 비교가 의미 없습니다).
CREATE ROLLUP시점에 위반 사항이 있으면 에러로 생성이 거부됩니다.
조건부 롤업과 Custom Rollup의 WHERE 차이
- 조건부 롤업은
ON/FROM문법의 외부WHERE를 사용합니다. - Custom Rollup(
INTO ... AS (SELECT ...))은SELECT내부WHERE만 지원합니다. - 따라서
CREATE ROLLUP ... INTO (...) AS (...) INTERVAL ... WHERE ...형태는 허용되지 않습니다. - 전체 문법은 Custom Rollup: 사용자 정의 집계와 DDL: CREATE ROLLUP을 참고합니다.
자동 선택 우선순위(힌트 없을 때)
ROLLUP_TABLE(<rollup_table_name>)힌트가 있으면 항상 그 롤업을 사용합니다.- 힌트가 없으면 주기/값 컬럼/JSON PATH가 맞는 후보 중 조건 없는 롤업을 우선 선택합니다.
- 조건 없는 롤업이 없으면 조건 있는 롤업을 사용합니다.
- 후보가 여러 개 남으면 기존 규칙을 따릅니다. 요청 주기를 나누어떨어지게 하는 가장 큰 주기를 고르고, 주기가 같으면 먼저 등록된 롤업을 사용합니다.
빠른 사용 예(회귀 테스트 시나리오 기반)
- SUMMARIZED 컬럼
value외에value2 DOUBLE,status INTEGER처럼 필터에 사용할 컬럼이 있는 태그 테이블을 만듭니다. - 조건 없는 롤업과 조건 있는 롤업을 함께 만듭니다.
CREATE ROLLUP _tag_rollup_plain_1s     ON tag_bulk(value) INTERVAL 1 SEC;
CREATE ROLLUP _tag_rollup_plain_1m     FROM _tag_rollup_plain_1s INTERVAL 1 MIN;
CREATE ROLLUP _tag_rollup_cond_1s      ON tag_bulk(value) INTERVAL 1 SEC
  WHERE value2 >= 50 AND status >= 2;
CREATE ROLLUP _tag_rollup_cond_1m      FROM _tag_rollup_cond_1s INTERVAL 1 MIN;

-- FIRST()/LAST()를 쓰려면 EXTENSION 롤업 필요
CREATE ROLLUP _tag_rollup_plain_1s_ext ON tag_bulk(value) INTERVAL 1 SEC EXTENSION;
CREATE ROLLUP _tag_rollup_cond_1s_ext  ON tag_bulk(value) INTERVAL 1 SEC EXTENSION
WHERE value2 >= 50 AND status >= 2;- 데이터를 적재(bulk loader 또는 INSERT)한 뒤, 집계 결과를 바로 쓰려면 강제로 플러시합니다.
_TAG_BULK_ROLLUP_SEC에 대한ROLLUP_FORCE는 소스 테이블을WITH ROLLUP으로 생성한 경우에만 실행합니다.
EXEC ROLLUP_FORCE(_TAG_BULK_ROLLUP_SEC);   -- WITH ROLLUP으로 생성된 기본 롤업
EXEC ROLLUP_FORCE(_tag_rollup_plain_1s);
EXEC ROLLUP_FORCE(_tag_rollup_cond_1s);- 힌트 없이 조회하면 조건 없는 롤업이 자동으로 사용됩니다.
SELECT rollup('sec', 30, time) AS rt, AVG(value), COUNT(value)
FROM   tag_bulk
WHERE  name = 'dev9' AND time BETWEEN '2020-01-02 00:00:00' AND '2020-01-02 00:10:00'
GROUP BY rt
ORDER BY rt;- 반드시 필터된 집계를 써야 할 때는 힌트를 지정합니다.
SELECT /*+ ROLLUP_TABLE(_tag_rollup_cond_1s) */
       rollup('sec', 30, time) AS rt, AVG(value), COUNT(value)
FROM   tag_bulk
WHERE  name = 'dev9' AND time BETWEEN '2020-01-02 00:00:00' AND '2020-01-02 00:10:00'
GROUP BY rt
ORDER BY rt;FIRST()/LAST()를 사용할 경우 힌트 대상이EXTENSION롤업이어야 합니다. 확장이 아닌 롤업에서는 이 함수를 사용할 수 없습니다.
메타 정보와 업그레이드 안내
V$ROLLUP의PREDICATE컬럼에서 롤업을 생성할 때 사용한 필터를 확인할 수 있습니다.- 이 컬럼을 추가하기 위해 메타 버전이 10.0으로 올라가며, 업그레이드 후 서버를 처음 기동할 때 카탈로그가 자동으로 갱신됩니다. 매우 오래되었거나 손상된 메타 등으로 업그레이드에 실패하면 서버를 중지하고 원본 DB를 보존한 상태에서 새 DB로 데이터를 복구하거나 이전한 뒤 롤업을 다시 생성하십시오.
- 롤업을 생성할 때는 기존 제약(주기 배수, 숫자형 대상 등)이 그대로 적용되며, 필터가 이 제약을 바꾸지 않습니다.
ROLLUP 테이블 시작/중지
rollup을 생성하면 워커 스레드가 자동으로 시작되며, 이후 프로시저 또는 SQL 구문으로 시작/중지를 제어할 수 있습니다.
-- 롤업 시작/중지
ALTER ROLLUP <rollup_name> START;
ALTER ROLLUP <rollup_name> STOP;

-- 동일한 기능의 프로시저
EXEC ROLLUP_START(<rollup_name>);
EXEC ROLLUP_STOP(<rollup_name>);
Wakeup 주기와 스케줄
- 각 롤업은 자체 wakeup 주기로 동작합니다. 기본값은 롤업 주기와 같지만, 더 짧게(롤업 경계에 맞도록 롤업 주기의 약수로) 설정해 더 자주 깨울 수 있습니다.
- wakeup 주기 변경 문법:
ALTER ROLLUP <rollup_name> SET WAKEUP INTERVAL <N> (SEC|MIN|HOUR);N은 0보다 커야 합니다.N을 초 단위로 환산한 값이 롤업 주기보다 크면 안 됩니다.- 롤업 주기가 wakeup 주기의 정수배가 아니면 에러가 발생합니다.
- 값을 변경하면 스레드를 즉시 깨운 뒤 다음 wakeup 일정을 다시 잡습니다.
- 관찰 포인트:
V$ROLLUP에서WAKEUP_INTERVAL,LAST_WAKEUP_TIME,NEXT_WAKEUP_TIME,RUN_STATE(INIT/SLEEPING/RUNNING)를 확인할 수 있습니다.show rollupgap에서도 마지막/다음 wakeup 시각과 실행 상태를 볼 수 있습니다.
ROLLUP 테이블 즉시 수집
rollup은 기본적으로 설정된 시간 간격마다 데이터를 집계합니다.
- ex) 1시간 단위 rollup이라면 1시간마다 한 번 데이터를 집계하고, 나머지 시간에는 대기합니다.
대기 시간을 건너뛰고 수동으로 데이터 집계를 강제로 실행할 수 있습니다.
-- 비블로킹: 스레드를 바로 깨우고 반환
ALTER ROLLUP <rollup_name> WAKEUP;

-- 블로킹: 즉시 집계 실행 후 완료까지 대기
ALTER ROLLUP <rollup_name> FORCE;
-- 동일한 기능의 프로시저
EXEC ROLLUP_FORCE(<rollup_name>);
Rollup Rebuild 참고
원본 TAG 데이터를 삭제하거나 이상 데이터를 정상 데이터로 재적재해도 기존 rollup 결과는 자동으로 되돌려지지 않습니다.
built-in rollup의 시간 범위 복원, EXEC ROLLUP_REBUILD(...) 사용법, custom rollup 수동 복구 절차는 Rollup Rebuild 사용자 가이드를 참고하십시오.
ROLLUP 테이블 삭제
Rollup을 삭제합니다.
DROP ROLLUP rollup_name- rollup_name : 삭제할 rollup 이름
- 제약조건: 삭제할 rollup을 source table로 참조하는 rollup이 있으면 에러가 발생합니다. rollup 간에 의존성이 있으면 rollup을 생성한 역순으로 삭제해야 합니다.
mach> create tag table tag (name varchar(20) primary key, time datetime basetime, value double summarized);
mach> create rollup _tag_rollup_1 on tag(value) interval 1 sec;
mach> create rollup _tag_rollup_2 on _tag_rollup_1 interval 1 min;
mach> create rollup _tag_rollup_3 on _tag_rollup_2 interval 1 hour;

위와 같이 생성했을 경우 참조 순서는 아래와 같다.

tag -> _tag_rollup_1 -> _tag_rollup_2 -> _tag_rollup_3

이 때 tag table이나, 중간에 있는 rollup을 삭제하려고 하면 에러가 발생합니다.

mach> drop rollup tag
> [ERR-02651: Dependent ROLLUP table exists.]
mach> drop rollup _tag_rollup_1
> [ERR-02651: Dependent ROLLUP table exists.]

아래 순서대로 삭제해야 정상적으로 삭제할 수 있습니다.

mach> drop rollup _tag_rollup_3;
mach> drop rollup _tag_rollup_2;
mach> drop rollup _tag_rollup_1;
mach> drop table tag;
TAG 테이블 삭제 시 ROLLUP 테이블 함께 삭제
CASCADE 키워드를 사용해 태그 테이블을 삭제하면, 그 태그 테이블에 종속된 롤업 테이블도 함께 삭제됩니다.
DROP TABLE TAG CASCADE;Mach> SHOW TABLES;
USER_NAME DB_NAME TABLE_NAME TABLE_TYPE
-----------------------------------------------------------------------------------------------------------------------------------------------
SYS MACHBASEDB TAGTBL TAGDATA
SYS MACHBASEDB _TAGTBL_DATA_0 KEYVALUE
SYS MACHBASEDB _TAGTBL_DATA_1 KEYVALUE
SYS MACHBASEDB _TAGTBL_DATA_2 KEYVALUE
SYS MACHBASEDB _TAGTBL_DATA_3 KEYVALUE
SYS MACHBASEDB _TAGTBL_META LOOKUP
SYS MACHBASEDB _TAGTBL_ROLLUP_HOUR KEYVALUE
SYS MACHBASEDB _TAGTBL_ROLLUP_MIN KEYVALUE
SYS MACHBASEDB _TAGTBL_ROLLUP_SEC KEYVALUE
[9] row(s) selected.
Elapsed time: 0.001
Mach>
Mach> DROP TABLE tagtbl CASCADE;
Dropped successfully.
Mach> show tables;
USER_NAME DB_NAME TABLE_NAME TABLE_TYPE
-----------------------------------------------------------------------------------------------------------------------------------------------
[0] row(s) selected.조회 문법
rollup_expr := ROLLUP(time_unit, period, basetime_column [, origin])

--ex)
SELECT ROLLUP('MIN', 30, time, '1970-01-01'), MIN(value), MAX(value), AVG(value) FROM tag ..
위와 같이 ROLLUP 키워드를 사용하면 해당하는 롤업 테이블에서 데이터를 가져옵니다.
- time_unit:
DATE_BIN()함수에서 사용할 수 있는 시간 단위 - period:
time_unit기준의 구간 길이. 단위별로 지정할 수 있는 범위는DATE_BIN()함수와 같습니다. - basetime_column:
BASETIME속성으로 지정된 태그 테이블의 DATETIME 형 컬럼 - origin: ROLLUP 시간 구간을 나눌 기준 시간. 지정하지 않으면 기본값
1970-01-01 00:00:00이 사용됩니다.
Deprecated (version <= 8.0.19)
8.0.19 이하 버전에서는 다음 ROLLUP 표현식을 사용합니다.rollup_expr := basetime_column ROLLUP n time_unit -- ex) SELECT time ROLLUP 30 MIN, MIN(value), MAX(value), AVG(value) FROM tag ..
위와 같이 BASETIME 속성으로 지정된 DATETIME 형 컬럼 뒤에 ROLLUP 절을 붙이면 롤업 테이블을 조회합니다.
TIME_UNIT에 따라 조회하는 롤업 테이블이 달라집니다.
| 시간 단위(축약어) | 조회 대상 롤업 테이블 |
|---|---|
| nanosecond (nsec) | SECOND |
| microsecond (usec) | SECOND |
| millisecond (msec) | SECOND |
| second (sec) | SECOND |
| minute (min) | MINUTE |
| hour | HOUR |
| day | HOUR |
| week | HOUR |
| month | HOUR |
| year | HOUR |
ROLLUP 절은 롤업 테이블을 직접 조회하므로, 집계 함수를 사용할 때 다음과 같은 특징이 있습니다.
- 숫자형 타입의 컬럼에 집계 함수를 호출해야 합니다. 단, 롤업 테이블이 지원하는 여섯 가지 집계 함수(SUM, COUNT, MIN, MAX, AVG, SUMSQ)만 사용할 수 있습니다.
- 확장 롤업에서는 FIRST, LAST도 추가로 지원합니다.
- ROLLUP 대상인 BASETIME 컬럼으로 GROUP BY를 직접 지정해야 합니다.
- 같은 ROLLUP 절을 GROUP BY에 그대로 써도 됩니다.
- 또는 ROLLUP 절에 별명(alias)을 붙이고, GROUP BY에 그 별명을 써도 됩니다.
SELECT   rollup('sec', 3, time) mtime, avg(value)
FROM     TAG
GROUP BY mtime;

-- deprecated
SELECT   time rollup 3 sec mtime, avg(value)
FROM     TAG
GROUP BY time rollup 3 sec mtime;

-- 또는
SELECT   time rollup 3 sec mtime, avg(value)
FROM     TAG
GROUP BY mtime;
데이터 샘플
아래는 롤업 테스트를 위한 샘플 데이터입니다.
create tag table TAG (name varchar(20) primary key, time datetime basetime, value double summarized) with rollup extension;

insert into tag metadata values ('TAG_0001');

insert into tag values('TAG_0001', '2018-01-01 01:00:01 000:000:000', 1);
insert into tag values('TAG_0001', '2018-01-01 01:00:02 000:000:000', 2);
insert into tag values('TAG_0001', '2018-01-01 01:01:01 000:000:000', 3);
insert into tag values('TAG_0001', '2018-01-01 01:01:02 000:000:000', 4);
insert into tag values('TAG_0001', '2018-01-01 01:02:01 000:000:000', 5);
insert into tag values('TAG_0001', '2018-01-01 01:02:02 000:000:000', 6);

insert into tag values('TAG_0001', '2018-01-01 02:00:01 000:000:000', 1);
insert into tag values('TAG_0001', '2018-01-01 02:00:02 000:000:000', 2);
insert into tag values('TAG_0001', '2018-01-01 02:01:01 000:000:000', 3);
insert into tag values('TAG_0001', '2018-01-01 02:01:02 000:000:000', 4);
insert into tag values('TAG_0001', '2018-01-01 02:02:01 000:000:000', 5);
insert into tag values('TAG_0001', '2018-01-01 02:02:02 000:000:000', 6);

insert into tag values('TAG_0001', '2018-01-01 03:00:01 000:000:000', 1);
insert into tag values('TAG_0001', '2018-01-01 03:00:02 000:000:000', 2);
insert into tag values('TAG_0001', '2018-01-01 03:01:01 000:000:000', 3);
insert into tag values('TAG_0001', '2018-01-01 03:01:02 000:000:000', 4);
insert into tag values('TAG_0001', '2018-01-01 03:02:01 000:000:000', 5);
insert into tag values('TAG_0001', '2018-01-01 03:02:02 000:000:000', 6);
태그 하나에 서로 다른 값 18건을 초 단위로 입력했으며, 데이터는 3개의 1시간 구간에 걸쳐 있습니다. 입력 직후 결과를 확인하려면 EXEC ROLLUP_FORCE(_TAG_ROLLUP_SEC), EXEC ROLLUP_FORCE(_TAG_ROLLUP_MIN), EXEC ROLLUP_FORCE(_TAG_ROLLUP_HOUR)를 차례로 실행합니다.
ROLLUP 평균값 얻기
아래는 해당 태그의 초, 분, 시 단위 평균값을 얻는 예제입니다.
Mach> SELECT rollup('sec', 1, time) as mtime, avg(value) FROM TAG WHERE name = 'TAG_0001' group by mtime order by mtime;
mtime                           avg(value)
---------------------------------------------------------------
2018-01-01 01:00:01 000:000:000 1
2018-01-01 01:00:02 000:000:000 2
2018-01-01 01:01:01 000:000:000 3
2018-01-01 01:01:02 000:000:000 4
2018-01-01 01:02:01 000:000:000 5
2018-01-01 01:02:02 000:000:000 6
2018-01-01 02:00:01 000:000:000 1
2018-01-01 02:00:02 000:000:000 2
2018-01-01 02:01:01 000:000:000 3
2018-01-01 02:01:02 000:000:000 4
2018-01-01 02:02:01 000:000:000 5
2018-01-01 02:02:02 000:000:000 6
2018-01-01 03:00:01 000:000:000 1
2018-01-01 03:00:02 000:000:000 2
2018-01-01 03:01:01 000:000:000 3
2018-01-01 03:01:02 000:000:000 4
2018-01-01 03:02:01 000:000:000 5
2018-01-01 03:02:02 000:000:000 6
[18] row(s) selected.

Mach> SELECT rollup('min', 1, time) as mtime, avg(value) FROM TAG WHERE name = 'TAG_0001' group by mtime order by mtime;
mtime                           avg(value)
---------------------------------------------------------------
2018-01-01 01:00:00 000:000:000 1.5
2018-01-01 01:01:00 000:000:000 3.5
2018-01-01 01:02:00 000:000:000 5.5
2018-01-01 02:00:00 000:000:000 1.5
2018-01-01 02:01:00 000:000:000 3.5
2018-01-01 02:02:00 000:000:000 5.5
2018-01-01 03:00:00 000:000:000 1.5
2018-01-01 03:01:00 000:000:000 3.5
2018-01-01 03:02:00 000:000:000 5.5
[9] row(s) selected.

Mach> SELECT rollup('hour', 1, time) as mtime, avg(value) FROM TAG WHERE name = 'TAG_0001' group by mtime order by mtime;
mtime                           avg(value)
---------------------------------------------------------------
2018-01-01 01:00:00 000:000:000 3.5
2018-01-01 02:00:00 000:000:000 3.5
2018-01-01 03:00:00 000:000:000 3.5
[3] row(s) selected.
ROLLUP 최소/최대값 얻기
아래는 해당 태그의 시간 구간별 최솟값과 최댓값을 얻는 예제입니다. 이전 예제와 달리 쿼리 한 번으로 최솟값과 최댓값을 함께 얻을 수 있습니다.
Mach> SELECT rollup('hour', 1, time) as mtime, min(value), max(value) FROM TAG WHERE name = 'TAG_0001' group by mtime order by mtime;
mtime                           min(value)                  max(value)
--------------------------------------------------------------------------------------------
2018-01-01 01:00:00 000:000:000 1                           6
2018-01-01 02:00:00 000:000:000 1                           6
2018-01-01 03:00:00 000:000:000 1                           6
[3] row(s) selected.

Mach> SELECT rollup('min', 1, time) as mtime, min(value), max(value) FROM TAG WHERE name = 'TAG_0001' group by mtime order by mtime;
mtime                           min(value)                  max(value)
--------------------------------------------------------------------------------------------
2018-01-01 01:00:00 000:000:000 1                           2
2018-01-01 01:01:00 000:000:000 3                           4
2018-01-01 01:02:00 000:000:000 5                           6
2018-01-01 02:00:00 000:000:000 1                           2
2018-01-01 02:01:00 000:000:000 3                           4
2018-01-01 02:02:00 000:000:000 5                           6
2018-01-01 03:00:00 000:000:000 1                           2
2018-01-01 03:01:00 000:000:000 3                           4
2018-01-01 03:02:00 000:000:000 5                           6
[9] row(s) selected.
ROLLUP 합계/개수 얻기
아래는 합계와 데이터 개수를 얻는 예제입니다. 이 경우에도 쿼리 한 번으로 합계와 개수를 함께 얻을 수 있습니다.
Mach> SELECT rollup('min', 1, time) as mtime, sum(value), count(value) FROM TAG WHERE name = 'TAG_0001' group by mtime order by mtime;
mtime                           sum(value)                  count(value)
-------------------------------------------------------------------------------------
2018-01-01 01:00:00 000:000:000 3                           2
2018-01-01 01:01:00 000:000:000 7                           2
2018-01-01 01:02:00 000:000:000 11                          2
2018-01-01 02:00:00 000:000:000 3                           2
2018-01-01 02:01:00 000:000:000 7                           2
2018-01-01 02:02:00 000:000:000 11                          2
2018-01-01 03:00:00 000:000:000 3                           2
2018-01-01 03:01:00 000:000:000 7                           2
2018-01-01 03:02:00 000:000:000 11                          2
[9] row(s) selected.
ROLLUP 제곱합 얻기
아래는 롤업에서 제곱합을 얻는 예제입니다.
Mach> SELECT rollup('sec', 1, time) as mtime, SUMSQ(value) FROM tag GROUP BY mtime ORDER BY mtime;
mtime                           SUMSQ(value)
---------------------------------------------------------------
2018-01-01 01:00:01 000:000:000 1
2018-01-01 01:00:02 000:000:000 4
2018-01-01 01:01:01 000:000:000 9
2018-01-01 01:01:02 000:000:000 16
2018-01-01 01:02:01 000:000:000 25
2018-01-01 01:02:02 000:000:000 36
2018-01-01 02:00:01 000:000:000 1
2018-01-01 02:00:02 000:000:000 4
2018-01-01 02:01:01 000:000:000 9
2018-01-01 02:01:02 000:000:000 16
2018-01-01 02:02:01 000:000:000 25
2018-01-01 02:02:02 000:000:000 36
2018-01-01 03:00:01 000:000:000 1
2018-01-01 03:00:02 000:000:000 4
2018-01-01 03:01:01 000:000:000 9
2018-01-01 03:01:02 000:000:000 16
2018-01-01 03:02:01 000:000:000 25
2018-01-01 03:02:02 000:000:000 36
[18] row(s) selected.

Mach> SELECT rollup('min', 1, time) as mtime, SUMSQ(value) FROM tag GROUP BY mtime ORDER BY mtime;
mtime                           SUMSQ(value)
---------------------------------------------------------------
2018-01-01 01:00:00 000:000:000 5
2018-01-01 01:01:00 000:000:000 25
2018-01-01 01:02:00 000:000:000 61
2018-01-01 02:00:00 000:000:000 5
2018-01-01 02:01:00 000:000:000 25
2018-01-01 02:02:00 000:000:000 61
2018-01-01 03:00:00 000:000:000 5
2018-01-01 03:01:00 000:000:000 25
2018-01-01 03:02:00 000:000:000 61
[9] row(s) selected.
JSON SUMMARIZED 대상의 ROLLUP 집계
value JSON SUMMARIZED를 사용하면 JSON 내부 경로를 하나씩 지정하지 않고 value 전체를 대상으로 ROLLUP 집계를 수행할 수 있습니다.
메트릭, 좌표, 카운터처럼 여러 숫자 leaf가 하나의 JSON 문서에 함께 들어오는 경우에 유용합니다. 집계 결과는 객체 구조를 유지하며, 숫자 leaf만 집계됩니다.
지원 범위
- DDL:
value JSON SUMMARIZED - 지원 집계 함수:
AVG(value),MIN(value),MAX(value),SUM(value),SUMSQ(value) - 개수 집계:
COUNT(value),COUNT(*) FIRST(time, value),LAST(time, value)는EXTENSION롤업에서만 사용 가능
대표 예제
-- Aggregate the full JSON document with the default rollup
CREATE TAG TABLE tag_json_rollup (
    name  VARCHAR(20) PRIMARY KEY,
    time  DATETIME BASETIME,
    value JSON SUMMARIZED
) WITH ROLLUP;

INSERT INTO tag_json_rollup VALUES ('HVAC_A', '2026-04-07 12:00:00', '{"metrics":{"temp":20,"pressure":1000},"location":{"x":6},"status":"ok"}');
INSERT INTO tag_json_rollup VALUES ('HVAC_A', '2026-04-07 12:00:01', '{"metrics":{"temp":22,"pressure":1002},"location":{"x":8},"status":true}');
INSERT INTO tag_json_rollup VALUES ('HVAC_A', '2026-04-07 12:00:02', '{"metrics":{"temp":24,"pressure":1004},"location":{"x":10},"status":null}');
-- If needed, use ROLLUP_FORCE or WAKEUP to collect immediately

SELECT rollup('hour', 1, time) AS mtime,
       COUNT(value), MIN(value), MAX(value), AVG(value), SUM(value), SUMSQ(value)
  FROM tag_json_rollup
 WHERE name = 'HVAC_A'
 GROUP BY mtime
 ORDER BY mtime;
-- Aggregate only numeric leaves when strings, booleans, and nulls are mixed in
CREATE TAG TABLE tag_json_mix (
name VARCHAR(20) PRIMARY KEY,
time DATETIME BASETIME,
value JSON SUMMARIZED
) WITH ROLLUP TAG_PARTITION_COUNT=1;
INSERT INTO tag_json_mix VALUES ('HVAC_B', '2026-04-07 13:00:00', '{"metrics":{"temp":10,"pressure":100},"location":{"x":1},"mode":"AUTO","enabled":false}');
INSERT INTO tag_json_mix VALUES ('HVAC_B', '2026-04-07 13:00:01', '{"metrics":{"temp":20,"pressure":200},"location":{"x":2},"mode":"MANUAL","enabled":true}');
INSERT INTO tag_json_mix VALUES ('HVAC_B', '2026-04-07 13:00:02', '{"metrics":{"temp":30,"pressure":300},"location":{"x":3},"mode":null,"enabled":null}');
-- If needed, use ROLLUP_FORCE or WAKEUP to collect immediately
SELECT rollup('hour', 1, time) AS mtime, COUNT(value), COUNT(*), AVG(value), MIN(value), MAX(value), SUM(value)
FROM tag_json_mix
GROUP BY mtime
ORDER BY mtime;-- Arrays are not flattened, and FIRST/LAST requires an EXTENSION rollup
CREATE TAG TABLE tag_json_mix2 (
name VARCHAR(20) PRIMARY KEY,
time DATETIME BASETIME,
value JSON SUMMARIZED
) WITH ROLLUP EXTENSION TAG_PARTITION_COUNT=1;
INSERT INTO tag_json_mix2 VALUES ('HVAC_C', '2026-04-07 14:00:00', '{"metrics":{"temp":1,"pressure":10}, "location":{"x":1}, "history":[1,2,3]}');
INSERT INTO tag_json_mix2 VALUES ('HVAC_C', '2026-04-07 14:00:01', '{"metrics":{"temp":3,"pressure":30}, "location":{"x":2}, "history":[4,5]}');
INSERT INTO tag_json_mix2 VALUES ('HVAC_C', '2026-04-07 14:00:02', '{"metrics":{"temp":5,"pressure":50}, "location":{"x":3}, "history":[6]}');
-- If needed, use ROLLUP_FORCE or WAKEUP to collect immediately
SELECT rollup('hour', 1, time) AS mtime,
COUNT(value),
AVG(value),
SUM(value),
FIRST(time, value),
LAST(time, value)
FROM tag_json_mix2
GROUP BY mtime
ORDER BY mtime;-- Build a RAW -> SEC -> MIN -> HOUR chain
CREATE TAG TABLE tag_json_chain (
name VARCHAR(20) PRIMARY KEY,
time DATETIME BASETIME,
value JSON SUMMARIZED
);
CREATE ROLLUP _tag_json_chain_sec ON tag_json_chain(value) INTERVAL 1 SEC;
CREATE ROLLUP _tag_json_chain_min ON _tag_json_chain_sec INTERVAL 1 MIN;
CREATE ROLLUP _tag_json_chain_hour ON _tag_json_chain_min INTERVAL 1 HOUR;SELECT rollup('hour', 1, time) AS mtime, COUNT(value), AVG(value), SUMSQ(value)
FROM tag_json_chain
GROUP BY mtime
ORDER BY mtime;잘못된 JSON은 INSERT 단계에서 거부되므로 롤업 집계에 포함되지 않습니다.
-- Invalid JSON is not inserted and therefore not aggregated
CREATE TAG TABLE tag_json_bad (
    name  VARCHAR(20) PRIMARY KEY,
    time  DATETIME BASETIME,
    value JSON SUMMARIZED
) WITH ROLLUP;

INSERT INTO tag_json_bad VALUES ('HVAC_D', '2026-04-07 15:00:00', '{"metrics":{"temp":1,"pressure":2},"location":{"x":1}}');
INSERT INTO tag_json_bad VALUES ('HVAC_D', '2026-04-07 15:00:01', '{"metrics":{"temp":1,"pressure":2},"location":{"x":1}');
-- Rows rejected at insert time are excluded from aggregation

SELECT rollup('hour', 1, time) AS mtime, COUNT(value), SUMSQ(value)
  FROM tag_json_bad
 GROUP BY mtime
 ORDER BY mtime;
동작 규칙
- 객체는 재귀적으로 병합되며, 경로의 합집합이 유지됩니다.
- 숫자 leaf만 집계합니다.
- 문자열/불리언/null/배열은 숫자 집계에서 제외되며, 배열은 내부 요소를 펼치지 않습니다.
- 누락된 경로는 결과 객체에 새로 만들어지지 않습니다.
- 같은 path의 중복 키는 마지막 값이 최종 반영됩니다(파서 정규화 기준).
COUNT(value)는value가 NULL이 아닌 행 수,COUNT(*)는 전체 행 수입니다.
사용 시 점검 사항
rollup('sec'|'min'|'hour', ...)결과에서 구조 유지와 숫자 leaf 집계 동작을 확인합니다.COUNT(value)와COUNT(*)를 각각 확인합니다.FIRST/LAST는EXTENSION롤업에서만 사용하는지 확인합니다.FIRST/LAST는 원본 JSON 문서 전체를 반환하므로, 문서 크기에 따른 네트워크 전송량과 스토리지 영향을 고려합니다.
ROLLUP 시작/종료 값 얻기
아래는 확장 롤업에서 제공하는 시작 및 종료 값을 얻는 예제입니다.
Mach> SELECT rollup('min', 1, time) as mtime, FIRST(time, value), LAST(time, value) FROM tag GROUP BY mtime ORDER BY mtime;
mtime                           FIRST(time, value)          LAST(time, value)
--------------------------------------------------------------------------------------------
2018-01-01 01:00:00 000:000:000 1                           2
2018-01-01 01:01:00 000:000:000 3                           4
2018-01-01 01:02:00 000:000:000 5                           6
2018-01-01 02:00:00 000:000:000 1                           2
2018-01-01 02:01:00 000:000:000 3                           4
2018-01-01 02:02:00 000:000:000 5                           6
2018-01-01 03:00:00 000:000:000 1                           2
2018-01-01 03:01:00 000:000:000 3                           4
2018-01-01 03:02:00 000:000:000 5                           6
[9] row(s) selected.

Mach> SELECT rollup('hour', 1, time) as mtime, FIRST(time, value), LAST(time, value) FROM tag GROUP BY mtime ORDER BY mtime;
mtime                           FIRST(time, value)          LAST(time, value)
--------------------------------------------------------------------------------------------
2018-01-01 01:00:00 000:000:000 1                           6
2018-01-01 02:00:00 000:000:000 1                           6
2018-01-01 03:00:00 000:000:000 1                           6
[3] row(s) selected.
다양한 시간 간격으로 그룹화
ROLLUP 절을 사용하면 시간 간격을 바꾸기 위해 DATE_BIN()을 따로 쓸 필요가 없습니다.
3초 간격의 합계와 데이터 개수는 아래와 같이 얻을 수 있습니다. 샘플 데이터는 각 분의 1초와 2초에만 값이 있으므로 모두 0초 구간으로 묶입니다. 그래서 결과가 분 단위 롤업 조회 결과와 같습니다.
Mach> SELECT rollup('sec', 3, time) as mtime, sum(value), count(value) FROM TAG WHERE name = 'TAG_0001' GROUP BY mtime ORDER BY mtime;
mtime                           sum(value)                  count(value)
-------------------------------------------------------------------------------------
2018-01-01 01:00:00 000:000:000 3                           2
2018-01-01 01:01:00 000:000:000 7                           2
2018-01-01 01:02:00 000:000:000 11                          2
2018-01-01 02:00:00 000:000:000 3                           2
2018-01-01 02:01:00 000:000:000 7                           2
2018-01-01 02:02:00 000:000:000 11                          2
2018-01-01 03:00:00 000:000:000 3                           2
2018-01-01 03:01:00 000:000:000 7                           2
2018-01-01 03:02:00 000:000:000 11                          2
1 Day 이상의 Rollup
아래 예제는 앞의 2018년 샘플과 별개로, 조회 기간의 매일 00:00:00에 데이터가 1건씩 있다고 가정한 출력 예시입니다.
Day Rollup
Mach> SELECT ROLLUP('day', 10, time, '2023-01-01') AS mtime, COUNT(value) FROM tag WHERE time BETWEEN TO_DATE('2023-05-01') AND TO_DATE('2023-05-31') GROUP BY mtime ORDER BY mtime;
mtime                           COUNT(value)
--------------------------------------------------------
2023-05-01 00:00:00 000:000:000 10
2023-05-11 00:00:00 000:000:000 10
2023-05-21 00:00:00 000:000:000 10
2023-05-31 00:00:00 000:000:000 1
[4] row(s) selected.
Week Rollup
origin을 지정하지 않으면 (목요일-수요일) 범위로 집계됩니다. (일요일-토요일) 범위로 집계하려면 origin에 일요일에 해당하는 datetime을 지정해야 합니다.
Mach> SELECT ROLLUP('week', 2, time, '2024-05-05') AS mtime, COUNT(value) FROM tag WHERE time BETWEEN TO_DATE('2024-05-01') AND TO_DATE('2024-05-31') GROUP BY mtime ORDER BY mtime;
mtime                           COUNT(value)
--------------------------------------------------------
2024-04-21 00:00:00 000:000:000 4
2024-05-05 00:00:00 000:000:000 14
2024-05-19 00:00:00 000:000:000 13
Month Rollup
origin은 항상 달의 첫날(1일)로 지정해야 합니다.
Mach> SELECT ROLLUP('month', 2, time) AS mtime, COUNT(value) FROM tag WHERE time BETWEEN to_date('2024-05-01') AND to_date('2024-07-31') GROUP BY mtime ORDER BY mtime;
mtime                           COUNT(value)
--------------------------------------------------------
2024-05-01 00:00:00 000:000:000 61
2024-07-01 00:00:00 000:000:000 31
[2] row(s) selected.
Mach> SELECT ROLLUP('month', 1, time, '2024-05-05') AS mtime, COUNT(value) FROM tag WHERE time BETWEEN to_date('2024-05-01') AND to_date('2024-07-31') GROUP BY mtime ORDER BY mtime;
mtime                           COUNT(value)
--------------------------------------------------------
[ERR-02356: Origin must be the first day of the month.]
Year Rollup
Mach> SELECT ROLLUP('year', 1, time, '2022-01-01') AS mtime, COUNT(value) FROM tag WHERE time BETWEEN TO_DATE('2022-01-01') AND TO_DATE('2023-12-31') GROUP BY mtime ORDER BY mtime;
mtime                           COUNT(value)
--------------------------------------------------------
2022-01-01 00:00:00 000:000:000 365
2023-01-01 00:00:00 000:000:000 365
[2] row(s) selected.