GROUP()
구문
GROUP( [lazy(boolean)] [, by()] [, aggregator...] )lazy(boolean): 지연 모드를 설정합니다(기본값false).by(value [, timewindow()] [, name]): 주어진 값으로 그룹을 어떻게 나눌지 지정합니다. 원래GROUP()에서by()는 필수였지만, Since v8.0.14 부터는 생략하고 전체 데이터에 한 번에 집계기를 적용할 수 있습니다.aggregator: 집계기 목록. 여러 집계 함수를 쉼표로 구분해 지정할 수 있습니다.
| |
결과
by()
by()는 첫 번째 인자로 값을 받고, 선택적으로 timewindow()와 name을 받습니다.
Syntax: by( value [, timewindow] [, label] )
value: 그룹의 기준 값. 보통 시간 또는 문자열입니다.timewindow(from, until, period): 시간 범위를 지정합니다.label: string, 새로운 컬럼 이름(기본값"GROUP").
lazy()
Syntax: lazy(boolean)
기본값인 false로 설정하면 GROUP()은 현재 레코드의 by() 값을 이전 레코드의 값과 비교해, 값이 달라질 때마다 새 레코드를 출력합니다.
따라서 연속된 레코드의 by() 값이 같을 때만 하나의 그룹이 만들어집니다.
lazy(true)로 설정하면 레코드를 출력하기 전에 입력 스트림의 끝까지 모든 레코드를 모으므로 정렬되지 않은 by() 값도 그룹화할 수 있지만, 메모리를 많이 사용합니다.
timewindow()
Syntax: timewindow( from, until, period )
Since v8.0.13
from,until: time, 시간 범위입니다. from은 범위에 포함되고 until은 포함되지 않습니다. 실제 데이터의 유무와 상관없이 원하는 시간 범위를 지정할 수 있습니다.period: duration, from과 until 사이를 나누는 시간 간격입니다.
timewindow 예제를 참고해 주십시오.
데이터베이스에 저장된 데이터를 분석하고 시각화하는 작업은 번거로울 수 있습니다. 원하는 시간 범위에 데이터가 없거나, 한 구간에 데이터가 여러 개 있는 경우에는 더욱 그렇습니다.
예를 들어 일정한 시간 간격으로 시간-값 차트를 그릴 때, SELECT 문으로 조회한 데이터를 그대로 차트 라이브러리에 넣으면 레코드 사이의 시간 간격이 차트의 시간 축과 맞지 않을 수 있습니다. 중간 데이터가 빠져 있거나 한 구간에 데이터가 몰려 있으면 이런 어긋남이 생기고, 원하는 모양으로 데이터를 다듬기 어려워집니다.
보통 애플리케이션 개발자는 일정한 시간 간격의 배열을 만들고, 조회 결과 레코드를 차례로 읽으면서 배열의 각 요소(슬롯)를 채웁니다. 슬롯에 이미 값이 있으면 특정 연산(예: min, max, first, last)으로 하나의 값만 유지합니다. 마지막으로 값이 없는 슬롯은 임의의 값(예: 0 또는 NULL)으로 채웁니다.
timewindow()를 이용하면 이러한 작업을 TQL 내에서 처리할 수 있습니다.
집계기(aggregator)
집계기를 지정하지 않으면 GROUP은 그룹마다 by() 값만 담은 레코드 하나를 만듭니다.
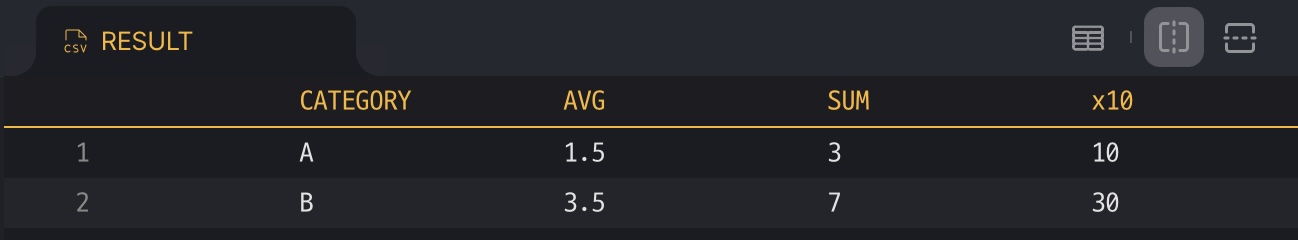
예를 들어 ["A",1], ["A",2], ["B",3] 레코드에 GROUP( by(value(0)) )를 적용하면 A, B 두 레코드가 만들어지고 나머지 값은 버려집니다.
그룹의 값을 남기려면 list() 같은 집계기를 지정합니다.
집계 함수
Syntax: function_name( value [, value...] [, where()] [, nullValue()] [, predict()] [, label])
value: 함수에 따라 하나 이상의 값을 전달합니다.where( predicate ): 조건식을 받아, 조건식이true인 값만 집계합니다.nullValue(alternative): 집계 결과로 낼 값이 없을 때NULL대신 사용할 값을 지정합니다.predict(algorithm): 집계 결과로 낼 값이 없을 때NULL대신 사용할 값을 예측하는 알고리즘을 지정합니다.label: string, 결과 컬럼 이름(기본값은 집계 함수 이름).
집계 함수는 두 가지 유형이 있습니다.
- Type 1 : 결과 후보 값만 유지하고 최종 값만 반환합니다.
- Type 2 : 그룹 전체 데이터를 보관하여 집계 결과를 계산한 뒤, 다음 그룹을 위해 메모리를 해제합니다.
GROUP()에서lazy(true)와 Type 2 함수를 함께 사용하면 관련 컬럼의 입력 데이터 전체를 메모리에 유지합니다.
공통 옵션
where(), nullValue(), predict(), label은 선택 인자이며, 아래 각 함수 구문의 option에 해당합니다.
where()
Syntax: where(predicate)
Since v8.0.13
where 예제를 참고해 주십시오.
nullValue()
Syntax: nullValue(alternative)
Since v8.0.13
nullValue 예제를 참고해 주십시오.
predict()
Syntax: predict(algorithm)
Since v8.0.13
predict 예제를 참고해 주십시오.
| algorithm | 설명 |
|---|---|
PiecewiseConstant | 왼쪽 연속인 구간별 상수(piecewise constant) 1차원 보간 |
PiecewiseLinear | 구간별 선형 1차원 보간 |
AkimaSpline | 값과 1차 미분이 연속인 구간별 3차(cubic) 1차원 보간. https://www.iue.tuwien.ac.at/phd/rottinger/node60.html 참고 |
FritschButland | 값과 1차 미분이 연속이고 단조성이 보장되는 구간별 3차(cubic) 1차원 보간. Fritsch, F. N. and Butland, J., “A method for constructing local monotone piecewise cubic interpolants” (1984), SIAM J. Sci. Statist. Comput., 5(2), pp. 300-304 참고 |
LinearRegression | 인접 값으로 선형 회귀 보간 |
함수 목록
아래 Type 1 함수의 x는 float 값입니다.
avg()
Type 1, Syntax: avg(x [, option...])
그룹 값의 평균입니다.
sum()
Type 1, Syntax: sum(x [, option...])
그룹 값의 합계입니다.
count()
Type 1, Syntax: count(x [, option...])
Since v8.0.13
그룹 값의 개수입니다.
first()
Type 1, Syntax: first(x [, option...])
그룹의 첫 번째 값입니다.
last()
Type 1, Syntax: last(x [, option...])
그룹의 마지막 값입니다.
min()
Type 1, Syntax: min(x [, option...])
그룹의 최소값입니다.
max()
Type 1, Syntax: max(x [, option...])
그룹의 최대값입니다.
rss()
Type 1, Syntax: rss(x [, option...])
Root Sum Square(제곱합의 제곱근)
rms()
Type 1, Syntax: rms(x [, option...])
Root Mean Square(제곱 평균의 제곱근)
list()
Type 2, Syntax: list(x [, option...])
Since v8.0.15
x: float 값
list()는 모든 x 값을 모아 각 값을 담은 하나의 리스트를 만듭니다.
JSON(rowsArray(true))나 FLATTEN()과 조합하면 다양한 형태로 결과를 가공할 수 있습니다.
| |
{
    "data": {
        "columns": ["GROUP", "LIST"],
        "types": ["string", "list"],
        "rows": [
            ["A", [1,2]],
            ["B", [3,4]],
            ["C", [5]]
        ]
    },
    "success": true,
    "reason": "success",
    "elapse": "220.375µs"
}lrs()
Type 2, Syntax: lrs(x, y [, weight(w)] [, option...])
Since v8.0.13
x: float 또는 timey: float 값weight(w): 생략하면 모든 가중치가 1입니다.
x-y를 직교 좌표계의 점으로 보고 선형 회귀의 기울기(Linear Regression Slope)를 구합니다. x는 숫자 또는 시간 타입입니다.
mean()
Type 2, Syntax: mean(x [, weight(w)] [, option...])
x: float 값weight(w): 생략하면 모든 가중치가 1입니다.
mean()은 그룹 값의 가중 평균을 계산합니다. 모든 가중치가 1이면 성능을 위해 가벼운 avg()를 사용하십시오.
mean($x$, weight($w$)) = $ \frac{\sum {w_i x_i}} {\sum {w_i}} $
cdf()
Type 2, Syntax: cdf(x, q [, weight(w)] [, option...])
Since v8.0.14
x: floatq: floatweight(w): 생략하면 모든 가중치가 1입니다.
cdf()는 x의 경험적 누적 분포 함수 값, 즉 q 이하인 표본의 비율을 반환합니다.
cdf()는 이론적으로 quantile() 함수의 역함수이지만, 모든 q 값에서 실제로 역함수가 되는 것은 아닙니다.
correlation()
Type 2, Syntax: correlation(x, y [, weight(w)] [, option...])
Since v8.0.14
x,y: float 값weight(w): 생략하면 모든 가중치가 1입니다.
correlation()은 x와 y 표본 사이의 가중 상관계수를 반환합니다.
correlation($x$, $y$, weight($w$)) = $ \frac{\sum {w_i (x_i - \bar{x}) (y_i - \bar{y})}} {stdX * stdY} $, ($\bar{x}$ = x의 평균, $\bar{y}$ = y의 평균)
covariance()
Type 2, Syntax: covariance(x, y [, weight(w)] [, option...])
Since v8.0.14
x,y: float 값weight(w): 생략하면 모든 가중치가 1입니다.
covariance()는 x와 y 표본 사이의 가중 공분산을 반환합니다.
covariance($x$, $y$, weight($w$)) = $ \frac{\sum {w_i (x_i - \bar{x}) (y_i - \bar{y})}} { \sum {w_i} -1 } $, ($\bar{x}$ = x의 평균, $\bar{y}$ = y의 평균)
quantile()
Type 2, Syntax: quantile(x, p [, weight(w)] [, option...])
Since v8.0.13
x: float 값p: float, 비율weight(w): 생략하면 모든 가중치가 1입니다.
quantile()은 그 값 이하인 표본의 비율이 p 이상이 되는 x의 표본 값을 반환합니다. p는 0과 1 사이의 수여야 합니다.
q 이하인 표본의 비율이 p 이상이 되는 가장 작은 값 q를 반환합니다.
quantileInterpolated()
Type 2, Syntax: quantileInterpolated(x, p [, weight(w)] [, option...])
Since v8.0.13
x: float 값p: float, 비율weight(w): 생략하면 모든 가중치가 1입니다.
quantile()은 그 값 이하인 표본의 비율이 p 이상이 되는 x의 표본 값을 반환합니다. p는 0과 1 사이의 수여야 합니다.
quantileInterpolated()는 선형 보간한 값을 반환합니다.
median()
Type 2, Syntax: median(x [, weight(w)] [, option...])
x: float 값weight(w): 생략하면 모든 가중치가 1입니다.
quantile(x, 0.5 [, option...])과 같습니다.
medianInterpolated()
Type 2, Syntax: medianInterpolated(x [, weight(w)] [, option...])
x: float 값weight(w): 생략하면 모든 가중치가 1입니다.
quantileInterpolated(x, 0.5 [, option...])과 같습니다.
stddev()
Type 2, Syntax: stddev(x [, weight(w)] [, option...])
weight(w): 생략하면 모든 가중치가 1입니다.
stddev()는 표본 표준편차를 반환합니다.
stderr()
Type 2, Syntax: stderr(x [, weight(w)] [, option...])
weight(w): 생략하면 모든 가중치가 1입니다.
stderr()는 주어진 값의 표준편차로 계산한 평균의 표준오차를 반환합니다.
entropy()
Type 2, Syntax: entropy(x [, option...])
분포의 샤논 엔트로피입니다. 자연로그를 사용합니다.
mode()
Type 2, Syntax: mode(x [, weight(w)] [, option...])
weight(w): 생략하면 모든 가중치가 1입니다.
mode()는 value로 지정한 데이터와 주어진 가중치를 기준으로 가장 자주 나타나는 값을 반환합니다.
값을 비교할 때 float64의 엄격한 동등 비교를 사용하므로 주의해야 합니다.
최빈값이 여러 개이면 그중 어느 값이든 반환될 수 있습니다.
moment()
Type 2, Syntax: moment(x, n [, weight(w)] [, option...])
Since v8.0.14
x: float64 값n: float64, 모멘트 차수weight(w): 생략하면 모든 가중치가 1입니다.
moment()는 표본의 가중 n차 모멘트를 계산합니다.
variance()
Type 2, Syntax: variance(x [, weight(w)] [, option...])
Since v8.0.14
x: float 값weight(w): 생략하면 모든 가중치가 1입니다.
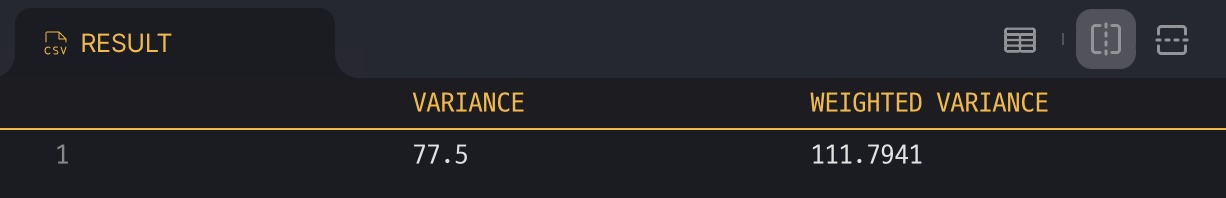
variance()는 그룹 값의 불편 가중 분산을 계산합니다.
가중치의 합이 1 이하이면 편향 분산 추정량을 사용해야 합니다.
| |
예제
timewindow()
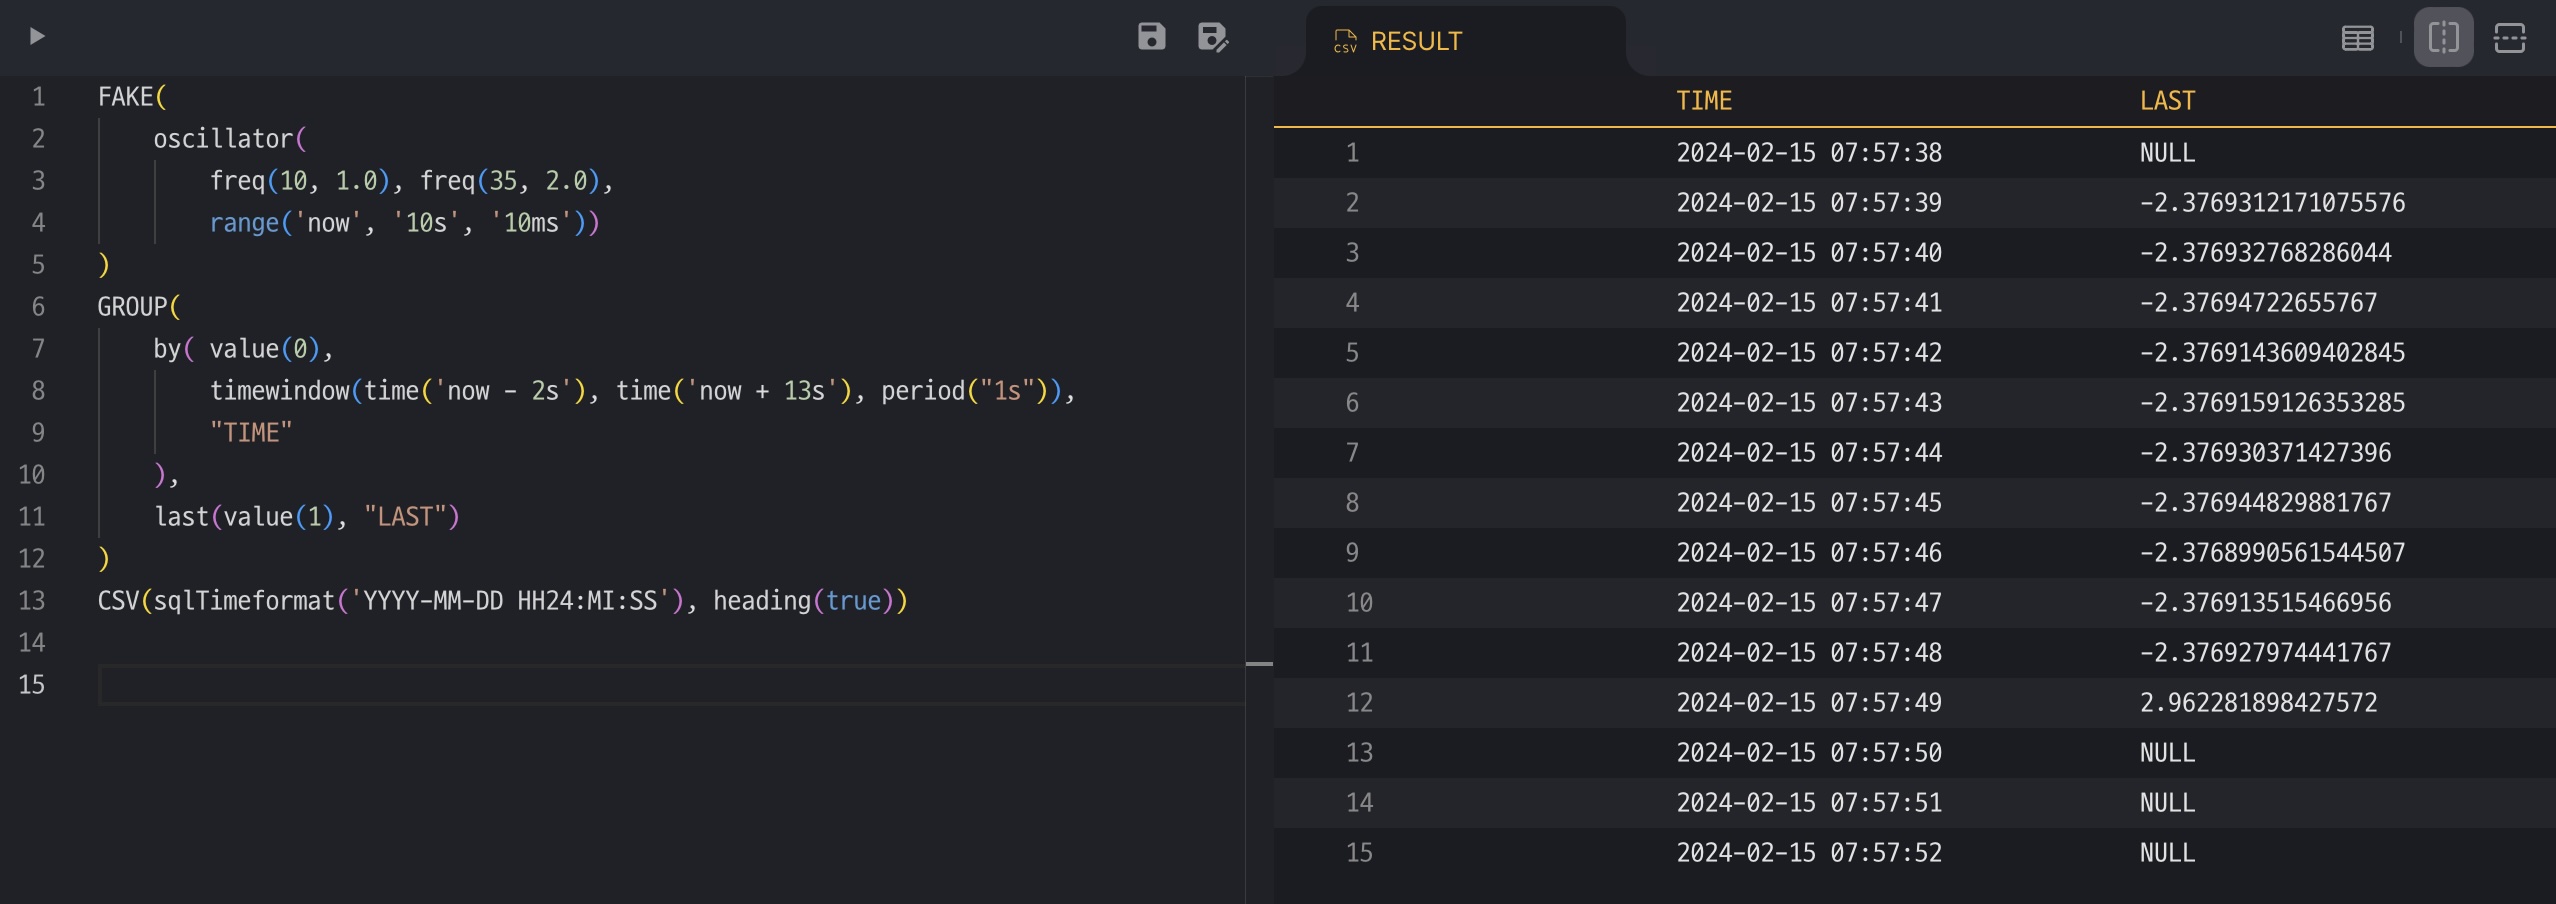
FAKE()는 10ms마다 시간-값 레코드를 생성하므로 1초에 100개의 레코드가 있습니다.
아래 TQL을 실행하면 1초 간격(timewindow()의 period("1s"))으로 데이터를 만들고,
원하는 시간 구간에 실제 데이터(레코드)가 없으면 기본값인 NULL로 채웁니다.
| |
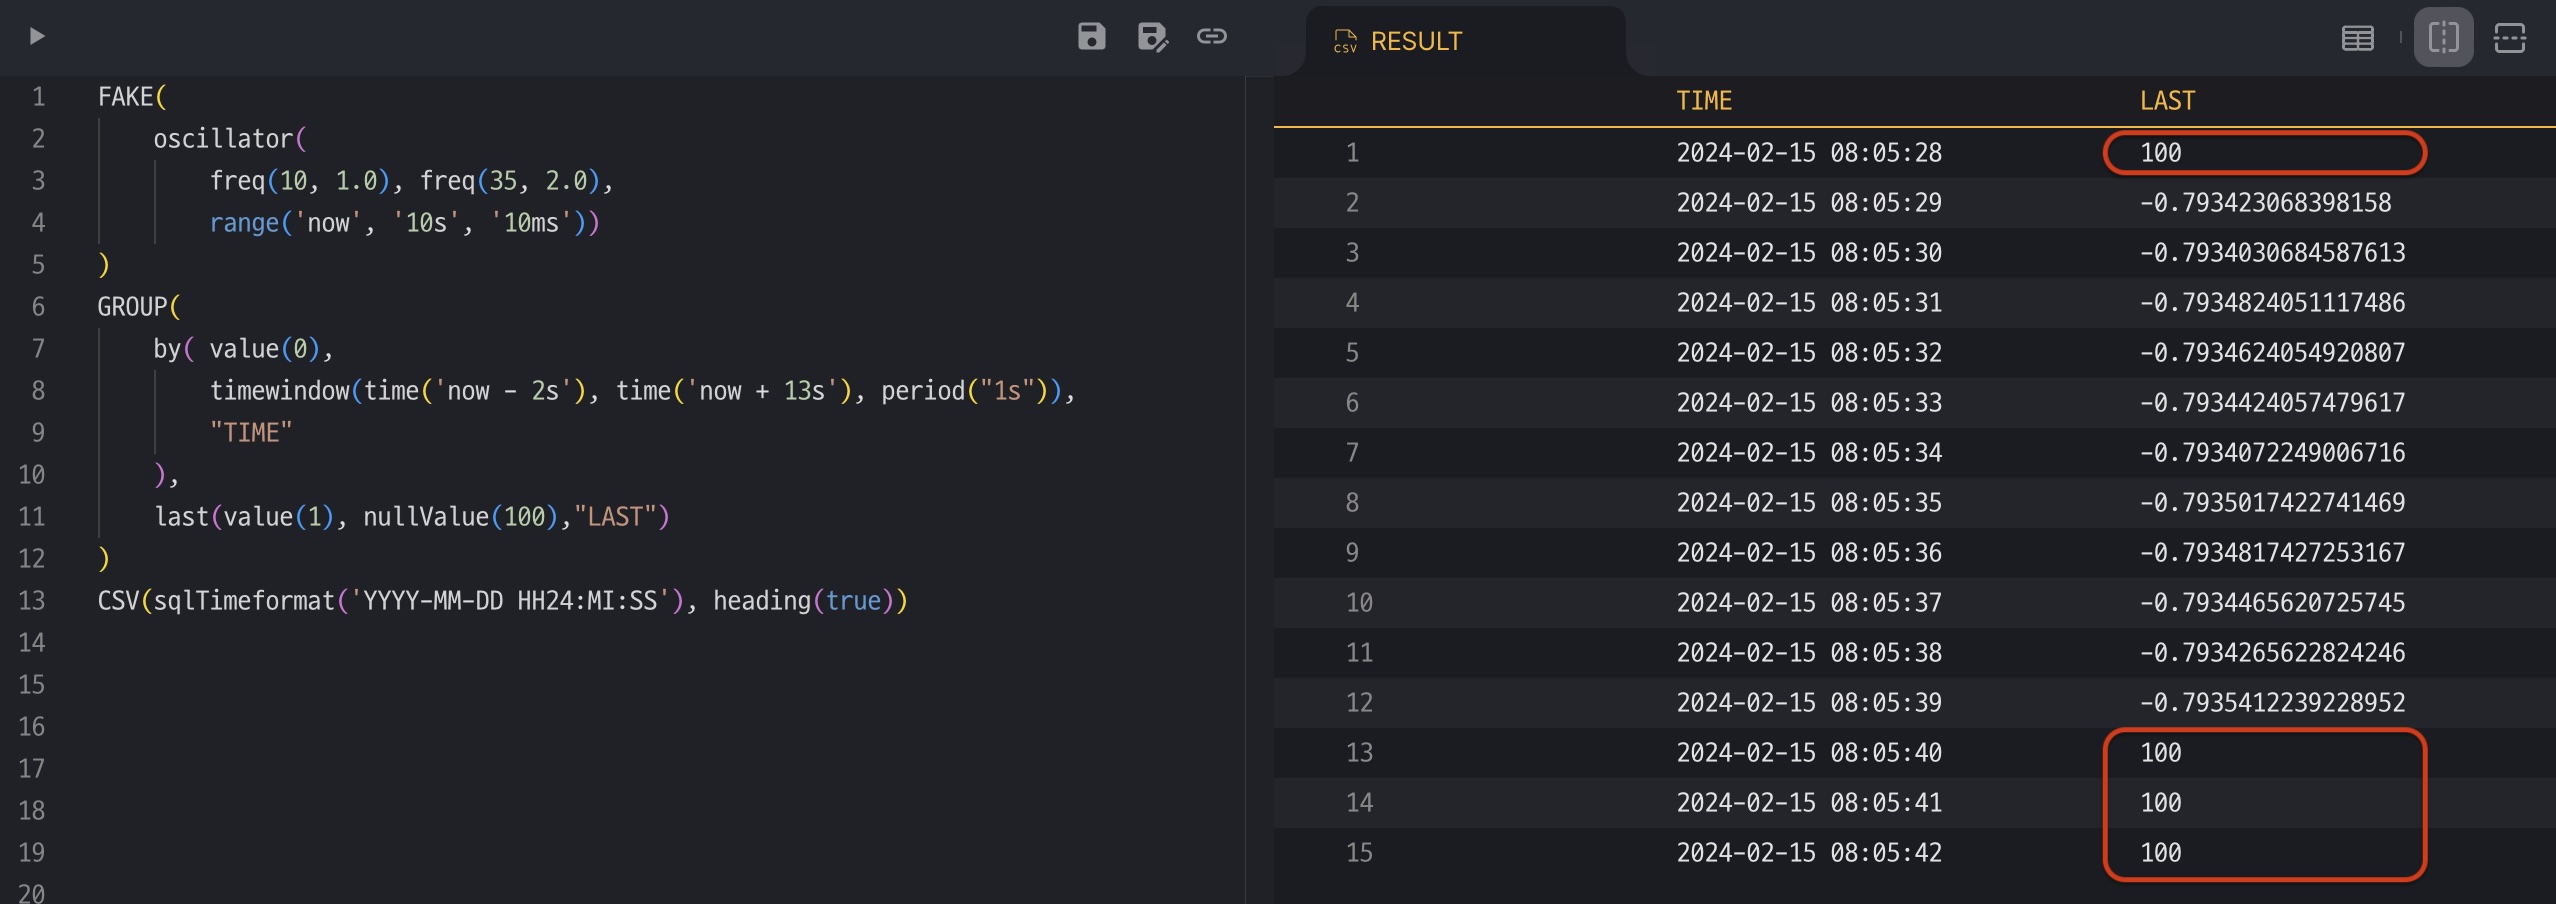
nullValue()
nullValue(100)을 추가해 다시 실행합니다. NULL 값이 지정한 값 100으로 바뀝니다.
| |
predict()
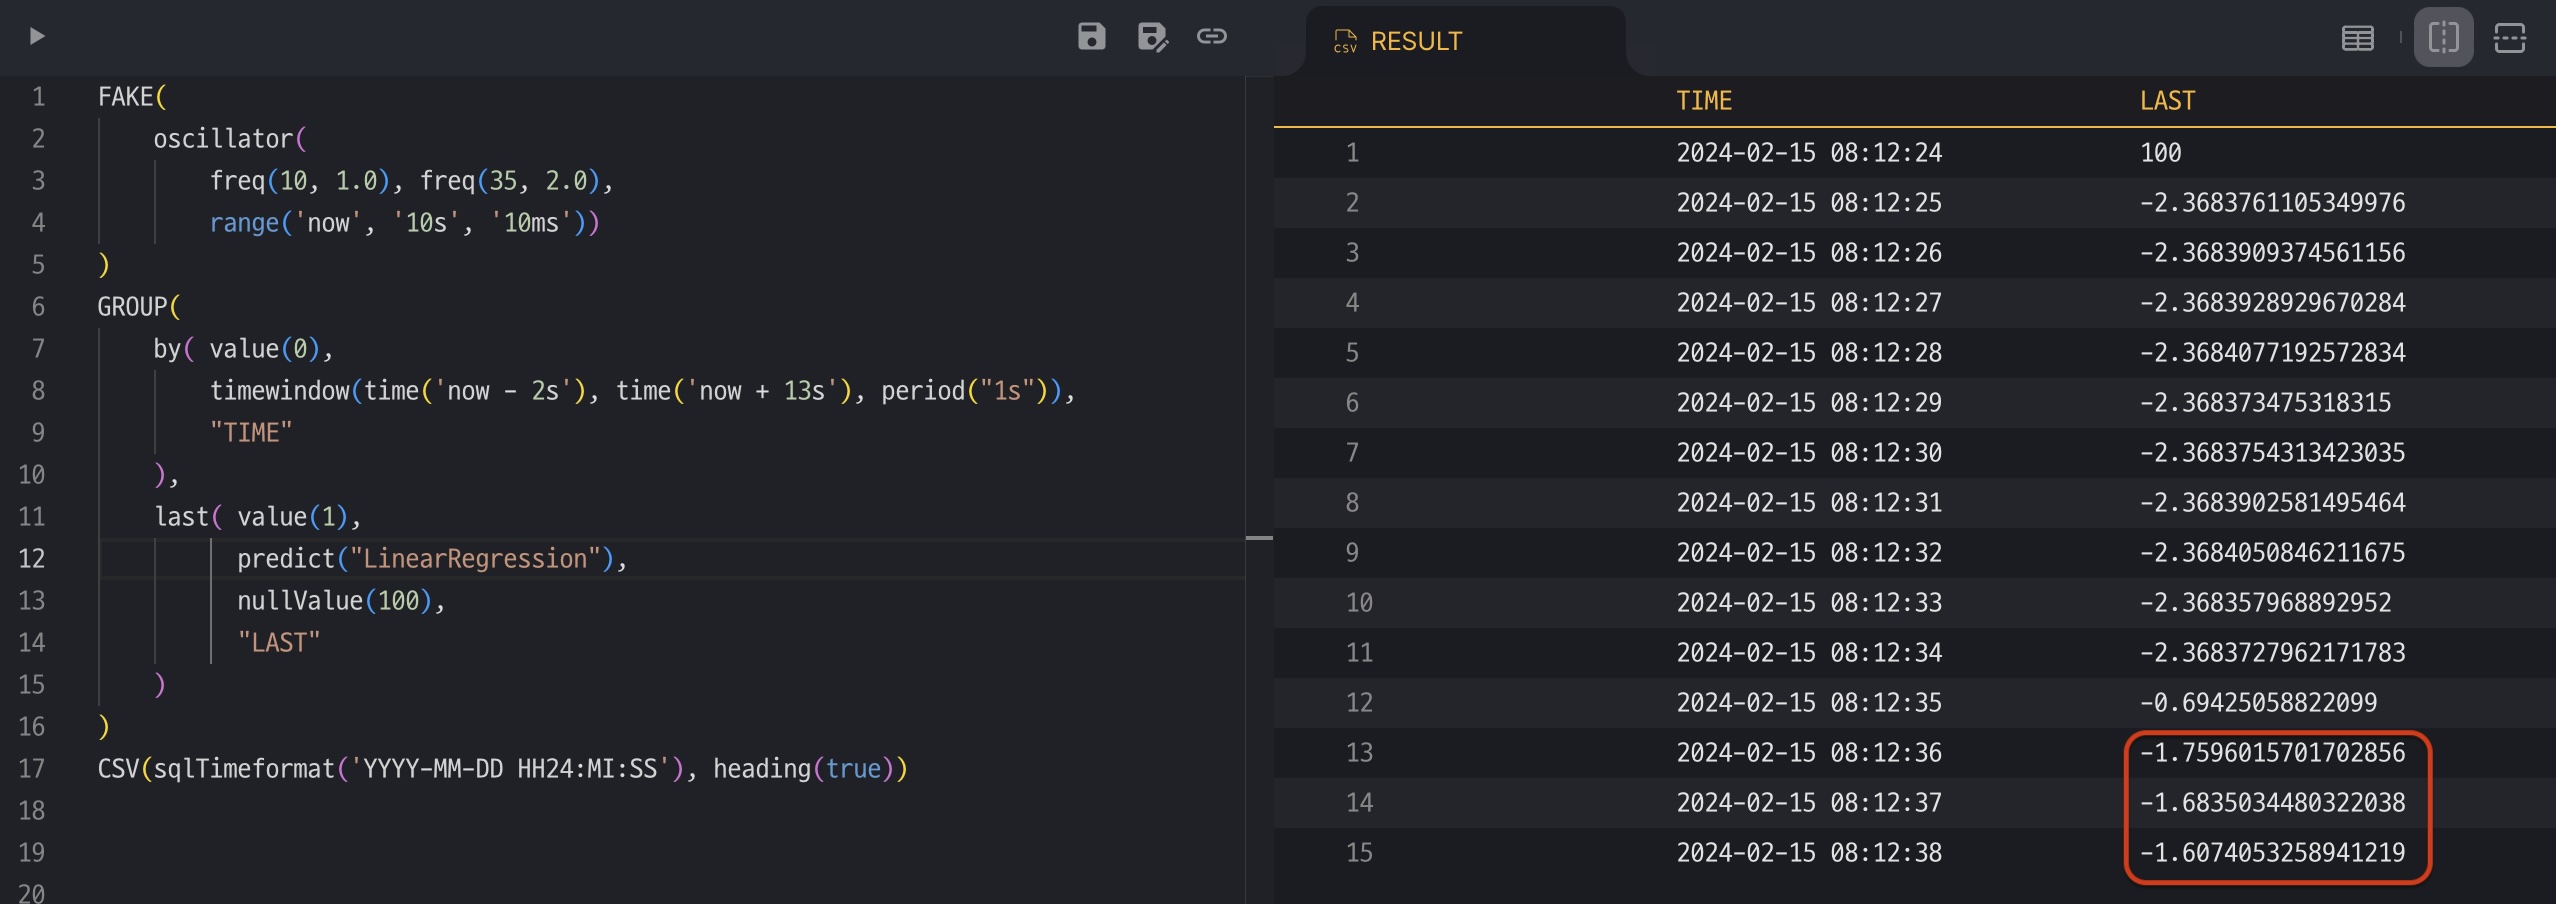
nullValue()로 빈 값(NULL)을 상수로 채우는 것에 그치지 않고, 인접 값을 참조해 보간한 데이터를 얻을 수도 있습니다.
위 예제의 last()에 predict("LinearRegression")을 추가해 다시 실행하십시오. 값이 없어 NULL을 반환하던 레코드에 선형 회귀로 예측한 값이 채워집니다.
예측에 필요한 인접 값이 부족하면 predict()가 보간 값을 만들지 못할 수 있으며, 이때는 nullValue()가 대신 적용됩니다. nullValue()를 지정하지 않았다면 NULL을 반환합니다.
| |
where()
온도와 습도를 측정하는 센서가 두 개 있고, 각 센서가 1초마다 데이터를 저장한다고 가정합니다. 실제 환경에서는 센서 시스템 사이에 항상 시간 차이가 있으므로, 저장된 데이터는 아래 예시와 같을 수 있습니다.
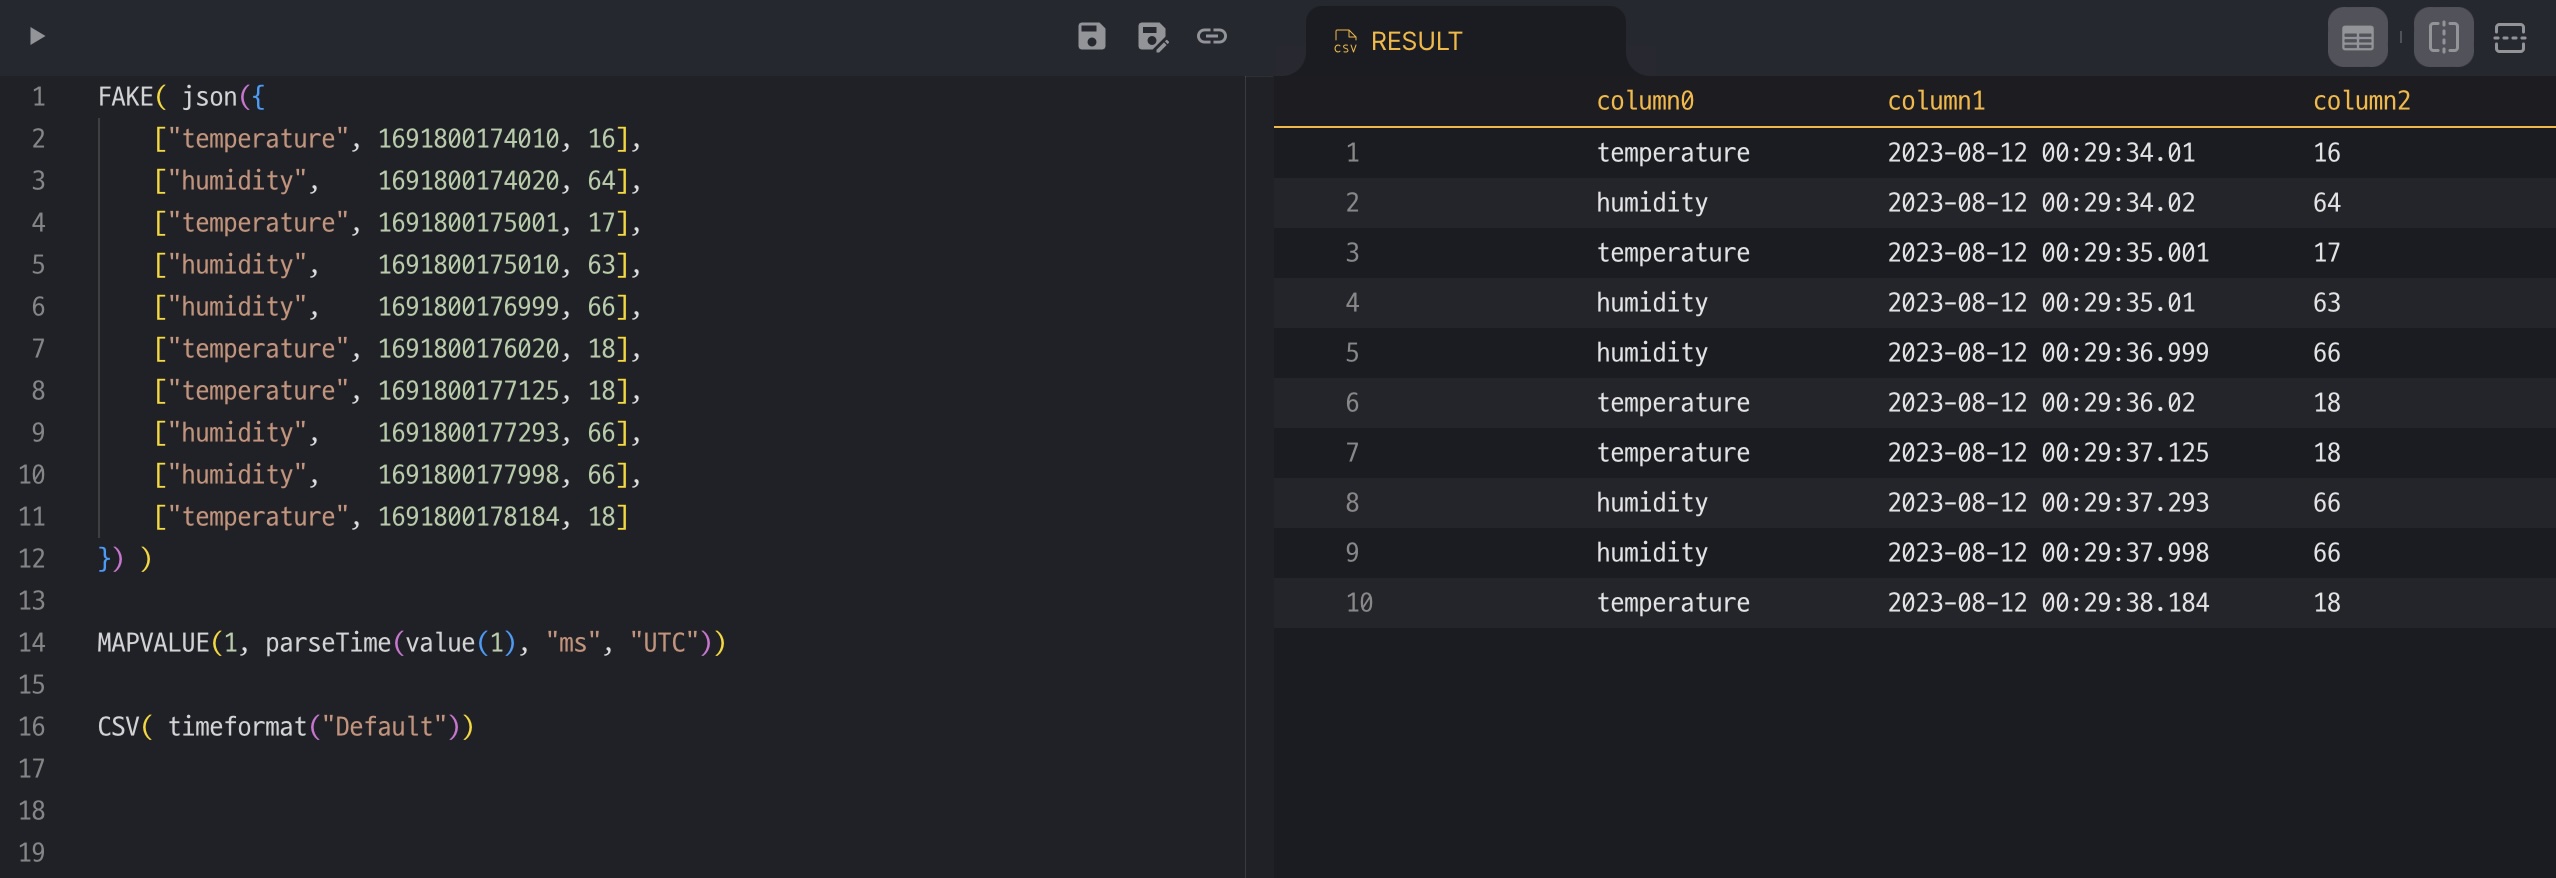
5번 레코드의 습도 데이터가 예상보다 일찍 저장되었고, 9번 레코드에서도 같은 일이 일어났습니다. 데이터를 초 단위로 정규화해 보겠습니다.
| |
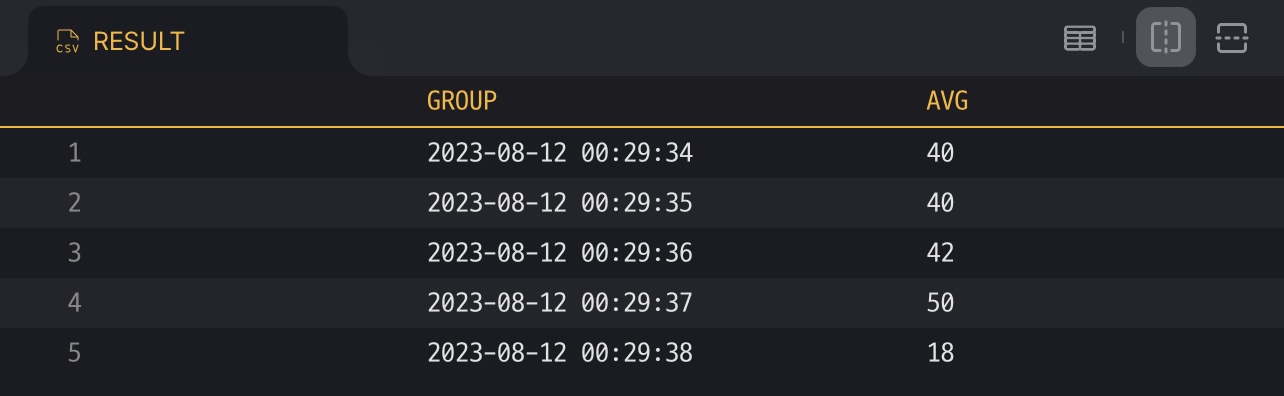
roundTime(..., "1s")로 시간 값을 초 단위로 맞춘 뒤, 시간이 같은 레코드를 그룹으로 묶습니다.
avg(...)는 그룹의 평균값을 계산합니다.
하지만 값이 온도인지 습도인지를 나타내는 첫 번째 컬럼 정보가 사라지므로 결과 값은 의미가 없어집니다.
이 문제는 where()로 해결합니다. 집계 함수는 where()의 조건식이 true일 때만 값을 받습니다.
| |
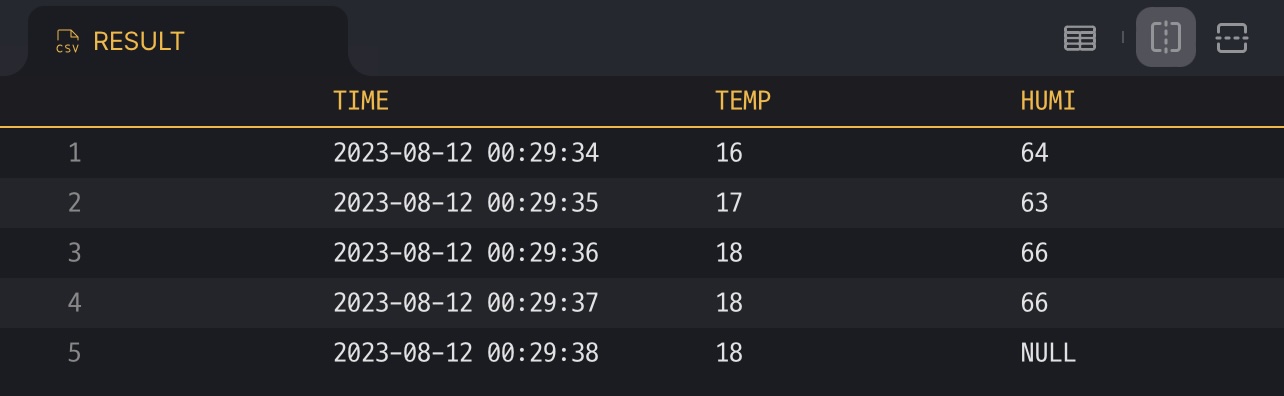
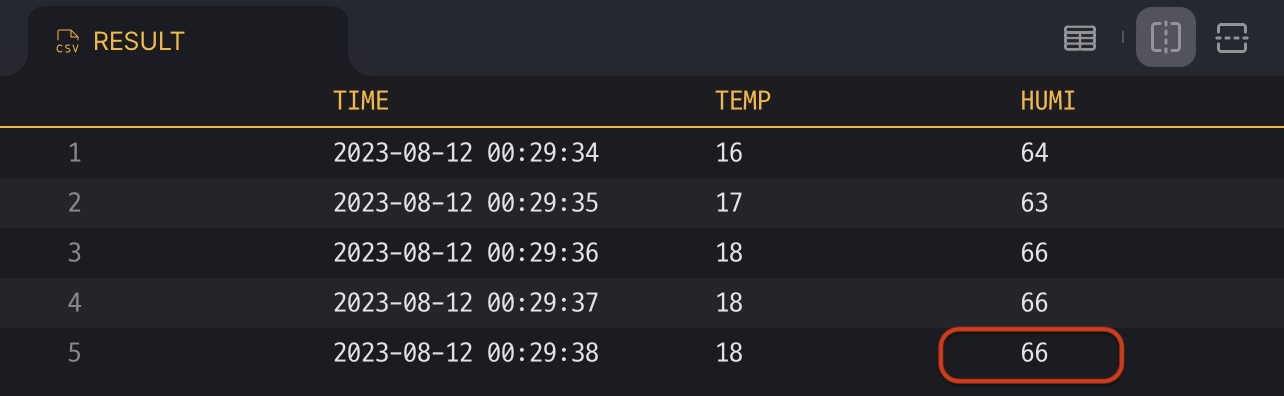
predict()와 nullValue()로 마지막 레코드의 빠진 데이터를 보간할 수도 있습니다.
| |
차트
| |
결과